Una llamada a una herramienta tardó 5.4 segundos. El contexto que requería tardó 7 minutos 29 segundos en procesarse.
Esa fue la división en una ejecución instrumentada de mi flujo de trabajo de agente local. En una ejecución de un flujo de trabajo de diagnóstico de registros contra mi servidor de operaciones, la propia sonda remota tardó 5.428 segundos y terminó correctamente. Antes de que esa sonda pudiera ejecutarse, el mismo turno tardó aproximadamente 7 minutos 29 segundos en procesar 66,170 tokens de entrada de contexto necesario. La parte rápida fue la herramienta. La parte lenta fue todo lo que el flujo de trabajo necesitaba antes de poder invocar la herramienta.
Un agente en la nube útil incluye más que la respuesta del modelo. A su alrededor hay un flujo de trabajo: las habilidades que indican cómo debe realizarse un trabajo, las conexiones MCP que exponen herramientas y servicios, los permisos que deciden a qué se puede acceder y el navegador o el shell que ejecuta realmente el trabajo. Reproducir eso localmente significa reproducir el sistema, no apuntar una ventana de chat a una API de modelo.
El flujo de trabajo es el producto, no el punto de conexión
Conviene definir claramente dos elementos de ese vocabulario, porque la mayor parte de la dificultad está aquí y no en el modelo.
MCP, el Model Context Protocol, es la forma en que un anfitrión de agentes expone herramientas y servicios a un modelo. Cada servidor MCP publica un catálogo de herramientas que el modelo puede invocar y, detrás de esas herramientas, se encuentran las capacidades reales: archivos, repositorios, navegadores, bases de datos y servicios remotos. El anfitrión intermedia cada llamada, que es también donde se aplican los permisos.
Las habilidades son instrucciones de flujo de trabajo. Una habilidad indica cómo realizar un tipo concreto de trabajo: qué herramientas usar, qué recopilar, en qué orden, qué debe contener la salida. Le proporciona al modelo un procedimiento que debe seguir, aunque el modelo todavía puede omitir pasos y necesita verificación.
Por tanto, el sistema que importa son el anfitrión, el modelo, el runtime, los permisos y las conexiones a herramientas, todo junto. El anfitrión es la aplicación con la que interactúo; en mi caso, Kilo Desktop, Kilo en VS Code y AnythingLLM. El runtime hace funcionar el modelo. El modelo realiza el razonamiento. Las habilidades y las conexiones MCP determinan qué trabajo es incluso posible. Un endpoint de inferencia por sí solo no configura esas habilidades, conexiones o permisos para el anfitrión del agente.
Lo que estoy ejecutando
Mi pila de servicio es un servidor de llama.cpp compatible con OpenAI (CUDA, compilación b11852) que ejecuta Qwen 3 Coder Next (Q4_K_M). Los metadatos del modelo indican 79.67 mil millones de parámetros en total en 48 capas, y los pesos cuantizados ocupan aproximadamente 48 GB. La máquina cuenta con una RTX 4090 con 24 GB de VRAM, un Ryzen 9 3900X con 12 núcleos físicos y 24 hilos, y 128 GB de RAM del sistema. La capacidad de contexto configurada es de 131,072 tokens, con una respuesta máxima de 8,192 tokens.
Qwen 3 Coder Next es un modelo de mezcla de expertos. Esto significa que almacena muchos conjuntos de pesos de expertos independientes y activa solo un subconjunto de ellos por token. Por tanto, los pesos almacenados son grandes, aunque el cálculo de cada token solo toca una fracción de ellos. Para esta decisión de hardware, importa el tamaño de los pesos almacenados: alrededor de 48 GB incluso después de la cuantización.
Por qué el modelo no cabe en la GPU
Alrededor de 48 GB de pesos cuantizados frente a 24 GB de VRAM constituyen un problema aritmético, no de ajuste. La cuantización Q4_K_M reduce el almacenamiento de los pesos a costa de precisión y calidad, pero no hace que este modelo quepa en 24 GB, especialmente cuando el contexto y los búferes del runtime también necesitan VRAM.
La solución es una colocación dividida. Los pesos de expertos de las primeras 32 de las 48 capas se asignan al lado de la CPU y la RAM del sistema; los demás tensores permanecen en la GPU, con una caché de expertos en la GPU de tamaño limitado. Para ser preciso, no se trata de 32 capas completas ejecutándose únicamente en la CPU: en un modelo de mezcla de expertos, esas capas contienen pesos de expertos, y son los pesos de los expertos de esas primeras 32 capas los que residen en la RAM del sistema.
Además: una caché de expertos en la GPU de 1,024 MiB, una caché KV Q8 y Flash Attention. Los pesos del modelo solo son una parte del uso de memoria de la GPU. El runtime también necesita búferes de trabajo y estado de atención, que suele denominarse caché KV. Q8 controla la precisión de almacenamiento de los tensores de caché compatibles. La caché de expertos de 1 GiB y Flash Attention son compensaciones adicionales entre memoria y cálculo; no se aisló su contribución individual en esta ejecución.
Por qué se ha incluido cada elemento
Son opciones prácticas para una máquina y una carga de trabajo, no óptimas demostradas mediante pruebas de rendimiento.
| Elección | Justificación | Matiz |
|---|---|---|
| Runtime de llama.cpp | Expone controles explícitos de cuantización y colocación de capas, y sirve una API compatible con OpenAI que el anfitrión del agente puede consumir | Es un runtime, no un modelo; cambiarlo no vuelve más inteligente al mismo modelo |
| Modelo MoE orientado a la programación | Un intento de admitir una carga real de tareas y herramientas en lugar de una demostración de chat | No se ha demostrado que sea igual a los modelos de primer nivel en la nube; ejecuciones locales anteriores aún necesitaban corrección humana |
| Cuantización Q4_K_M | Reduce el almacenamiento de los pesos lo suficiente para que la colocación híbrida sea viable | Es una compensación entre precisión y calidad, no una ventaja sin coste |
| División entre CPU y GPU | La VRAM es limitada y los pesos la superan | Los pesos de expertos de las primeras 32 de 48 capas residen en la RAM del sistema; el resto se ejecuta en la GPU |
| Límite de contexto de 128K | Margen para instrucciones, definiciones de habilidades y herramientas, entrada de la tarea, resultados de herramientas y salida | Una capacidad configurada, no un requisito por turno |
| Una solicitud concurrente, 12 hilos de CPU | Contiene la demanda de memoria frente a la RAM y los núcleos físicos disponibles | No se ha demostrado que sea óptimo para otras cargas de trabajo |
| Servicio nativo en Windows | Evitó el límite de 32 GB de RAM de la VM de WSL y las dificultades de cargar el modelo mediante archivos montados en Windows | Los comandos operativos Linux propios de Kilo siguen ejecutándose dentro de WSL |
Lo que hizo realmente una ejecución
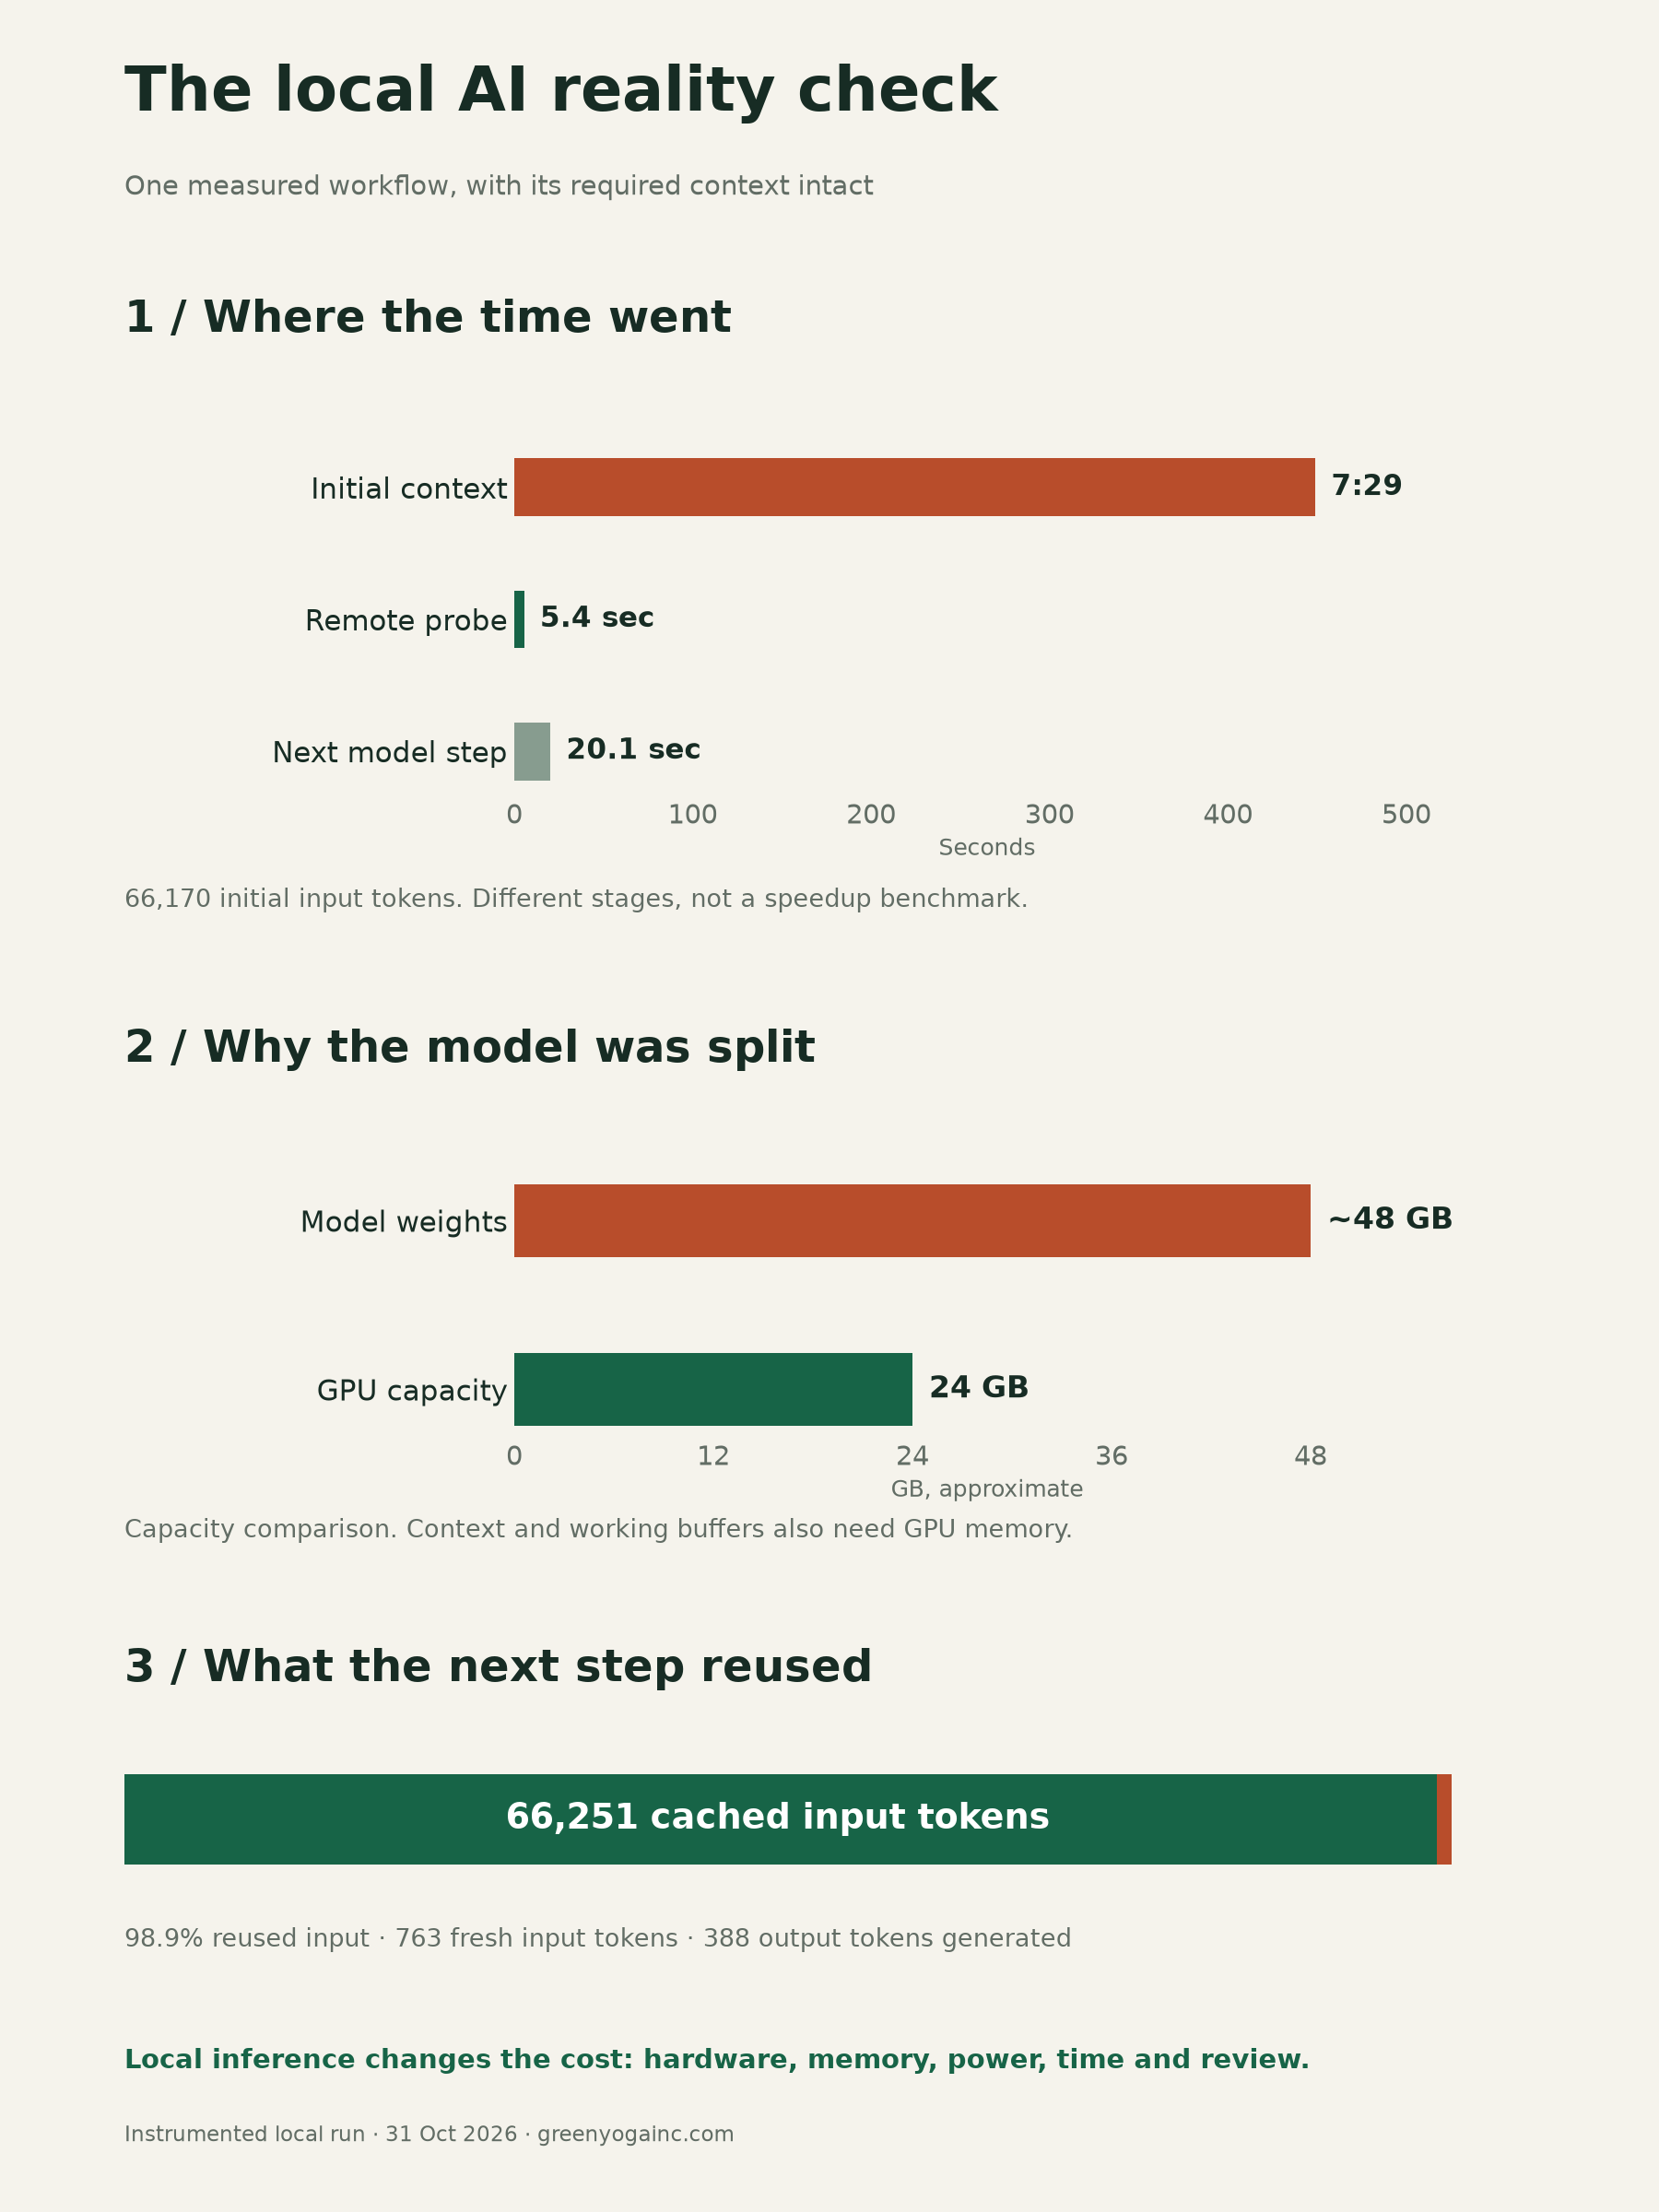
| Etapa | Duración | Detalle |
|---|---|---|
| Procesamiento de la entrada y el contexto | 448.92 s (7 min 29 s) | 66,170 tokens de entrada iniciales, unos 147 tokens de entrada/sec efectivos |
| Sonda remota de diagnóstico de registros | 5.428 s | Código de salida 0, contra mi servidor de operaciones |
| Respuesta posterior del modelo | 20.1 s | 66,251 tokens de entrada reutilizados, 763 nuevos, 388 tokens de salida, aproximadamente el 98.9% reutilizado |
Estas son tres etapas distintas de una misma ejecución, no comparaciones equivalentes. Los 448.92 segundos corresponden al procesamiento en frío de un contexto grande, observado una vez en un flujo de trabajo. Los 5.428 segundos son el tiempo de la sonda remota al realizar su trabajo. Los 20.1 segundos corresponden a un segundo paso del modelo después de que la herramienta devolviera el resultado. Interpretar 449 segundos frente a 20.1 segundos como una aceleración de la misma tarea sería incorrecto, porque el trabajo era diferente y el segundo paso heredó un prefijo caliente.
De dónde procedió la reutilización
Ese paso posterior reutilizó 66,251 tokens de entrada y procesó 763 nuevos; aproximadamente el 98.9% se reutilizó. Aquí es fácil confundir dos mecanismos distintos, por lo que conviene separarlos. La caché KV almacena el estado de atención para que los tokens anteriores no tengan que recalcularse de la misma forma en cada paso de generación; Q8 es una elección de precisión de almacenamiento. La reutilización de prefijos es un comportamiento: el motor detectó que el principio de la solicitud coincidía con lo que ya había procesado y se saltó volver a procesar esa parte. Ninguna de las dos reduce los pesos del modelo, y ninguna constituye un descuento en la facturación de la nube. La contabilidad de la caché de entrada en un proveedor de nube es un mecanismo distinto, con sus propias reglas y tarifas.
La disponibilidad es un problema aparte
El 31 de octubre de 2026, mi sesión de Kilo Desktop se quedó con un indicador de carga, así que pedí que se investigara la sesión bloqueada. La causa no fue la calidad del modelo, el tamaño del contexto ni un error de herramienta. El servidor local del modelo estaba apagado. Kilo siguió reintentando y recibiendo ECONNREFUSED, y el indicador nunca dejó clara la causa.
Al iniciar el servidor se restableció la sesión existente. No hizo falta descartar el contexto ni repetir el trabajo. La solución duradera fue un lanzador bajo demanda: iniciar el servidor, esperar a que estuviera listo y, a continuación, abrir Kilo. No se añadió nada al inicio de sesión de Windows, opción que prefería en una máquina que también uso de forma interactiva. La configuración de llama.cpp y Qwen ya estaba en marcha antes de este incidente; el incidente cambió cómo se inicia el servidor, no cómo se sirve el modelo.
Merece la pena mencionarlo porque representa la lección opuesta a la de los tiempos anteriores. Un modelo rápido en un servidor no disponible no produce absolutamente nada.
El coste del prompt, con honestidad
El prompt de esta ejecución era grande porque el flujo de trabajo lo exigía. Las instrucciones, las definiciones de habilidades y herramientas, la tarea y el espacio para los resultados de las herramientas suman, y no tengo intención de eliminar habilidades o conexiones MCP para que una cifra parezca mejor. Una prueba de rendimiento basada en un flujo de trabajo despojado de sus componentes no describe a un agente operativo.
Por tanto, compare las categorías de coste con honestidad en lugar de agruparlas.
Los planes en la nube pueden facturar de forma distinta los tokens de entrada, los tokens de salida y la entrada almacenada en caché. El término de entrada sin caché es aproximadamente los tokens de entrada divididos entre un millón, multiplicados por el precio de entrada del proveedor por millón. La facturación de la salida y los posibles descuentos de caché dependen del proveedor y del plan. Por ello, la facturación real depende del proveedor y del nivel de precios, y no inventaré una cifra en dólares.
La inferencia local elimina los cargos por token de API para ese modelo local. No elimina los cargos de herramientas de pago o servicios remotos, y no es gratuita. Los costes son el hardware, la memoria y la capacidad de VRAM, el consumo eléctrico, el mantenimiento de la configuración, el tiempo real que se pasa esperando y la revisión humana de la salida. Esos costes son reales y no disminuyen porque la inferencia sea local.
Un punto que suele pasarse por alto: la inferencia local no convierte las llamadas MCP remotas en locales ni sin conexión. Mis herramientas siguen accediendo a servicios remotos a través de la red. El trabajo que sale de mi máquina es el tráfico de las herramientas, y el modelo que decide qué llamar solo es una parte de la exposición.
Mantenga también separados la capacidad de contexto de 128K y los 66,170 tokens procesados. Lo primero es un ajuste; lo segundo, lo que este turno envió realmente. Ninguno de los dos equivale a tokens facturables, ni a los costes de completar la tarea.
Lo que muestra esta ejecución y lo que no muestra
El resultado observado fue modesto y real: la sonda de habilidad en directo se completó contra mi servidor de operaciones, Kilo produjo un informe y el informe volvió con pruebas para que una persona las revisara. La sonda y la respuesta terminaron. Eso por sí solo no demuestra que se siguieran todas las instrucciones de las habilidades ni que todas las conclusiones fueran correctas.
Ese es el criterio que realmente me importa: la finalización y la corrección, no la velocidad. Esperar siete minutos y medio es un resultado aceptable cuando el agente sigue su habilidad, llama a las herramientas adecuadas y devuelve algo revisable. Una respuesta inacabada no tiene valor para este flujo de trabajo.
De esto no se deduce que esta configuración sea fiable en general, que iguale a un modelo de primer nivel en la nube ni que los tiempos aquí predigan los suyos. Una ejecución es una ejecución. Y un gráfico del tiempo de procesamiento del prompt mide el coste de alimentar el modelo, no la calidad de lo que produjo. La finalización, la calidad de la salida y el coste de la revisión determinan si merece la pena ejecutar el flujo de trabajo.
Si está ejecutando tareas con un agente localmente, ¿cuál es su presupuesto de procesamiento de prompts y cómo decide si merece la pena esperar por un turno lento?
Nota de evidencia: Estas cifras proceden de una única ejecución local instrumentada de un usuario, el 31 de octubre de 2026, con tiempos aproximados en un único flujo de trabajo real. No son una prueba de rendimiento estandarizada, ni una comparación controlada de Ollama frente a llama.cpp, ni una comparación de rendimiento o coste entre la nube y el entorno local.