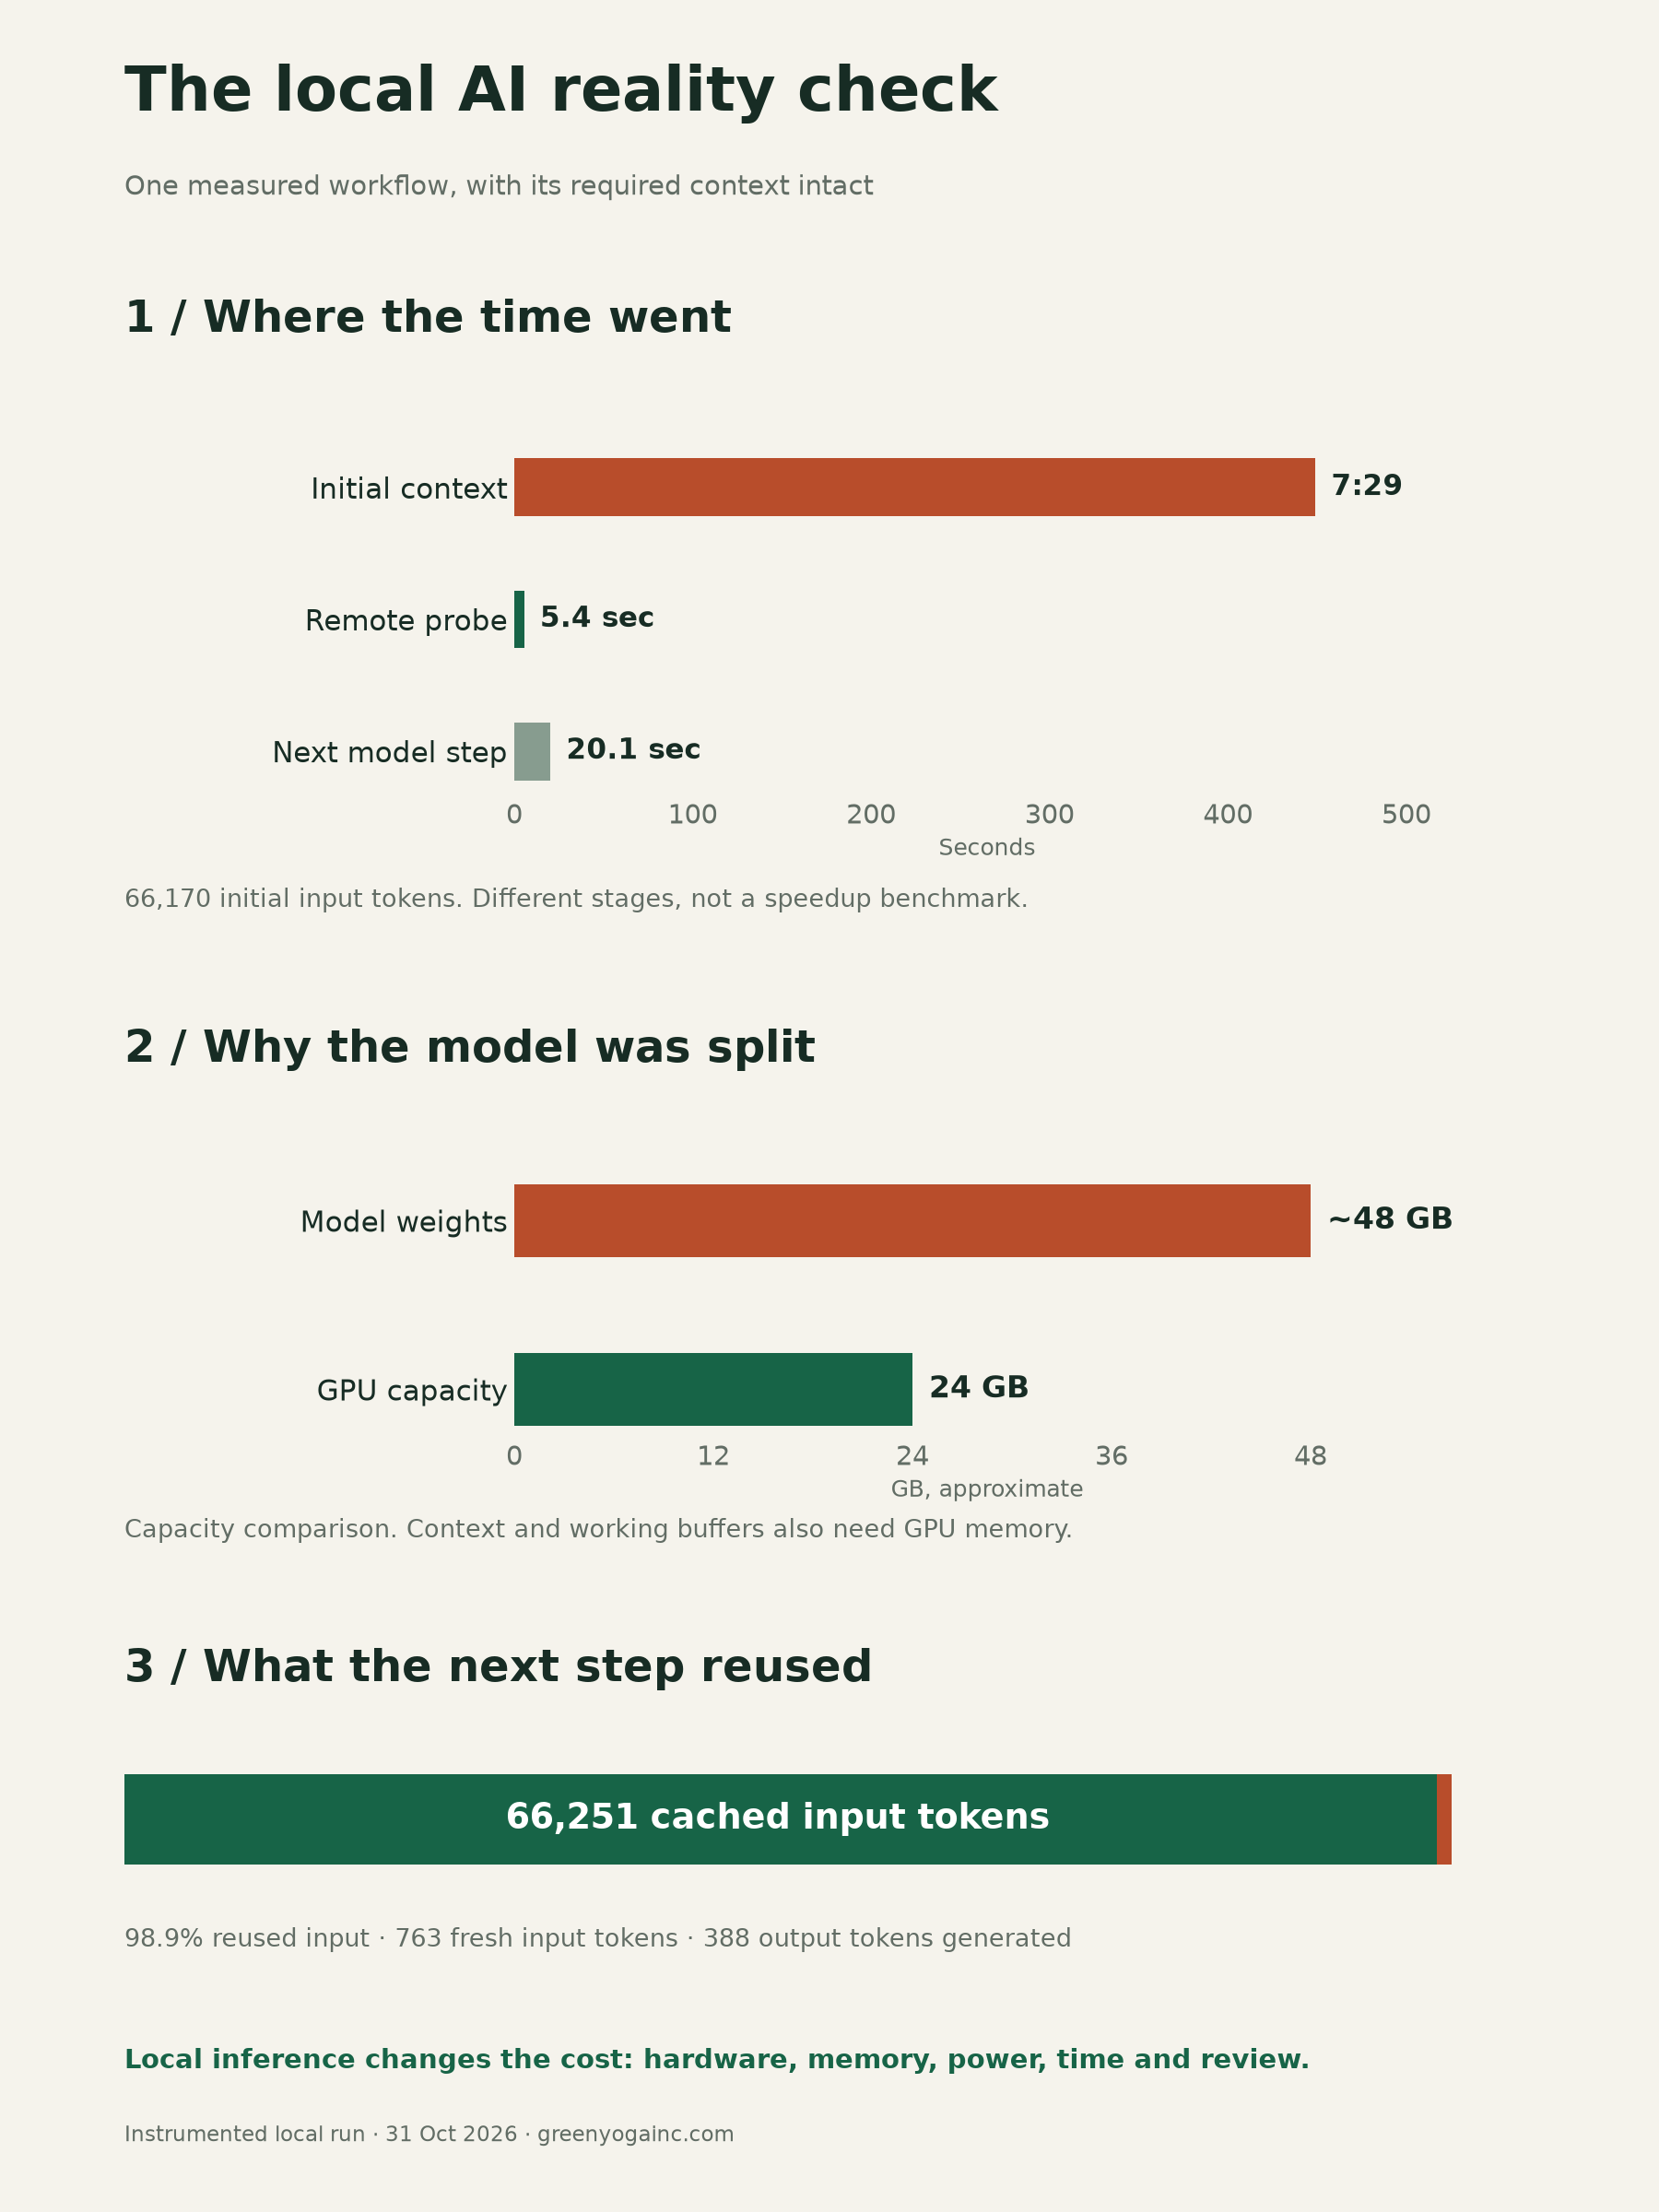
Uma chamada de ferramenta demorou 5,4 segundos. O contexto de que necessitava demorou 7 minutos e 29 segundos a ser processado.
Foi essa a divisão numa execução instrumentada do meu fluxo de trabalho do agente local. Numa execução de um fluxo de trabalho de análise de registos contra o meu servidor de operações, a própria sonda remota demorou 5,428 segundos e terminou corretamente. Antes de essa sonda poder ser executada, o mesmo turno gastou aproximadamente 7 minutos e 29 segundos a processar 66 170 tokens de contexto de entrada necessários. A parte rápida foi a ferramenta. A parte lenta foi tudo aquilo de que o fluxo de trabalho precisava antes de a ferramenta poder ser chamada.
Um agente na nuvem útil inclui mais do que a resposta do modelo. Existe um fluxo de trabalho à sua volta: as competências que indicam como um trabalho deve ser executado, as ligações MCP que expõem ferramentas e serviços, as permissões que decidem o que pode ser acedido e o navegador ou a shell que executa efetivamente o trabalho. Reproduzir isso localmente significa reproduzir o sistema, não apontar uma janela de chat para uma API de modelo.
O fluxo de trabalho é o produto, não o endpoint
Vale a pena definir claramente dois termos desse vocabulário, porque a maior parte da dificuldade se encontra aqui e não no modelo.
MCP, o Model Context Protocol, é a forma como um host de agentes expõe ferramentas e serviços a um modelo. Cada servidor MCP publica um catálogo de ferramentas que o modelo pode chamar e, por trás dessas ferramentas, encontram-se as verdadeiras capacidades: ficheiros, repositórios, navegadores, bases de dados e serviços remotos. O host intermedia cada chamada, que é também onde as permissões são aplicadas.
As competências são instruções de fluxo de trabalho. Uma competência indica como executar um determinado tipo de trabalho: que ferramentas utilizar, que informação recolher, em que ordem, o que deve conter o resultado. Fornece ao modelo um procedimento a seguir, embora o modelo ainda possa omitir passos e necessite de verificação.
Por isso, o sistema que importa é constituído pelo host, pelo modelo, pelo runtime, pelas permissões e pelas ligações às ferramentas, em conjunto. O host é a aplicação com que interajo, no meu caso o Kilo Desktop, o Kilo no VS Code e o AnythingLLM. O runtime serve o modelo. O modelo realiza o raciocínio. As competências e as ligações MCP determinam que trabalho é sequer possível. Um endpoint de inferência, isoladamente, não configura essas competências, ligações ou permissões para o host do agente.
O que estou a executar
A minha pilha de disponibilização é um servidor llama.cpp compatível com OpenAI (CUDA, build b11852), que executa o Qwen 3 Coder Next (Q4_K_M). Os metadados do modelo indicam 79,67 mil milhões de parâmetros totais distribuídos por 48 camadas, e os pesos quantizados ocupam aproximadamente 48 GB. A máquina tem uma RTX 4090 com 24 GB de VRAM, um Ryzen 9 3900X com 12 núcleos físicos e 24 threads e 128 GB de RAM do sistema. A capacidade de contexto configurada é de 131 072 tokens, com uma resposta máxima de 8 192 tokens.
O Qwen 3 Coder Next é um modelo de mistura de especialistas. Isto significa que armazena vários conjuntos de pesos de especialistas separados e ativa apenas um subconjunto deles por token. Por isso, os pesos armazenados são grandes, apesar de o cálculo por token afetar apenas uma fração deles. Para esta decisão de hardware, o tamanho dos pesos armazenados é importante: cerca de 48 GB mesmo após a quantização.
Porque é que o modelo não cabe na GPU
Cerca de 48 GB de pesos quantizados face a 24 GB de VRAM constituem um problema aritmético, não um problema de otimização. A quantização Q4_K_M reduz o armazenamento dos pesos com uma compensação entre precisão e qualidade, mas não faz este modelo caber em 24 GB, especialmente quando o contexto e os buffers do runtime também precisam de VRAM.
A solução é uma colocação dividida. Os pesos dos especialistas das primeiras 32 das 48 camadas são atribuídos ao lado da CPU/RAM do sistema; os outros tensores permanecem na GPU, com uma cache de especialistas na GPU de tamanho limitado. Para ser preciso, não se trata de 32 camadas completas a executar apenas na CPU: num modelo de mistura de especialistas, essas camadas contêm pesos de especialistas, e são os pesos dos especialistas dessas primeiras 32 camadas que residem na RAM do sistema.
Acompanham isto: uma cache de especialistas na GPU de 1 024 MiB, uma cache KV Q8 e Flash Attention. Os pesos do modelo são apenas parte da utilização da memória da GPU. O runtime também precisa de buffers de trabalho e do estado de atenção, frequentemente denominado cache KV. Q8 controla a precisão de armazenamento dos tensores de cache suportados. A cache de especialistas de 1 GiB e a Flash Attention são compensações adicionais entre memória e computação; a respetiva contribuição individual não foi isolada nesta execução.
Porque é que cada elemento está aqui
Estas são escolhas práticas para uma máquina e uma carga de trabalho, não produtos ótimos comprovados por benchmarks.
| Escolha | Justificação | Limitação |
|---|---|---|
| Runtime llama.cpp | Expõe controlos explícitos de quantização e colocação de camadas e disponibiliza uma API compatível com OpenAI que o host do agente pode utilizar | É um runtime, não um modelo; alterá-lo não torna o mesmo modelo mais inteligente |
| Modelo MoE orientado para programação | Uma tentativa de apoiar uma carga de trabalho real de tarefas e ferramentas, em vez de uma demonstração de chat | Não está comprovado como equivalente aos modelos de fronteira na nuvem; execuções locais anteriores ainda exigiam correção humana |
| Quantização Q4_K_M | Reduz o armazenamento dos pesos o suficiente para permitir uma colocação híbrida | É uma compensação entre precisão e qualidade, não uma vitória sem custos |
| Divisão entre CPU e GPU | A VRAM é limitada e os pesos excedem-na | Os pesos dos especialistas das primeiras 32 das 48 camadas residem na RAM do sistema; o resto é executado na GPU |
| Limite de contexto de 128K | Margem para instruções, definições de competências e ferramentas, entrada da tarefa, resultados das ferramentas e saída | Uma capacidade configurada, não um requisito por turno |
| Um pedido simultâneo, 12 threads de CPU | Contém a procura de memória face à RAM e aos núcleos físicos disponíveis | Não foi demonstrado como ótimo para outras cargas de trabalho |
| Disponibilização nativa no Windows | Evitou o limite de 32 GB de RAM da VM do WSL e as dificuldades de carregamento do modelo através de ficheiros montados no Windows | Os comandos operacionais Linux próprios do Kilo continuam a ser executados dentro do WSL |
O que uma execução fez efetivamente
| Etapa | Duração | Detalhe |
|---|---|---|
| Processamento da entrada e do contexto | 448,92 s (7 min 29 s) | 66 170 tokens de entrada iniciais, cerca de 147 tokens de entrada/s efetivos |
| Sonda remota de análise de registos | 5,428 s | Código de saída 0, contra o meu servidor de operações |
| Resposta seguinte do modelo | 20,1 s | 66 251 tokens de entrada reutilizados, 763 novos, 388 tokens de saída, cerca de 98,9% reutilizados |
Estas são três etapas diferentes de uma execução, não comparações equivalentes. Os 448,92 segundos correspondem ao processamento inicial de um contexto grande, observado uma vez num fluxo de trabalho. Os 5,428 segundos correspondem à sonda remota a realizar o seu trabalho. Os 20,1 segundos correspondem a uma segunda etapa do modelo depois de a ferramenta ter retornado. Comparar 449 segundos com 20,1 segundos como uma aceleração da mesma tarefa seria incorreto, porque o trabalho era diferente e a segunda etapa herdou um prefixo já processado.
De onde veio a reutilização
Essa etapa seguinte reutilizou 66 251 tokens de entrada e processou 763 novos, aproximadamente 98,9% reutilizados. É fácil confundir dois mecanismos diferentes, por isso vale a pena separá-los. A cache KV armazena o estado de atenção, para que os tokens anteriores não tenham de ser recalculados da mesma forma em cada etapa de geração; Q8 é uma escolha de precisão de armazenamento. A reutilização de prefixos é um comportamento: o motor reparou que o início do pedido coincidia com o que já tinha processado e omitiu o reprocessamento dessa parte. Nenhum dos mecanismos reduz os pesos do modelo, e nenhum representa um desconto de faturação na nuvem. A contabilização da cache de entradas num fornecedor de nuvem é um mecanismo separado, com as suas próprias regras e tarifas.
A disponibilidade é um problema separado
A 31 de outubro de 2026, a minha sessão do Kilo Desktop ficou presa num indicador de carregamento, por isso solicitei a investigação da sessão bloqueada. A causa não foi a qualidade do modelo, o tamanho do contexto nem um erro de ferramenta. O servidor local do modelo estava desligado. O Kilo continuava a tentar novamente e a receber ECONNREFUSED, e o indicador de carregamento nunca tornou essa causa evidente.
Iniciar o servidor restaurou a sessão existente. Não foi necessário descartar contexto nem refazer trabalho. A solução duradoura foi um iniciador a pedido: iniciar o servidor, aguardar que estivesse pronto e depois abrir o Kilo. Não foi adicionado nada ao início de sessão do Windows, algo que preferia numa máquina que também utilizo interativamente. A configuração do llama.cpp e do Qwen já estava instalada antes disso; o incidente mudou a forma como o servidor é iniciado, não a forma como o modelo é disponibilizado.
Vale a pena mencionar porque se trata da lição oposta à dos tempos apresentados acima. Um modelo rápido num servidor indisponível não produz absolutamente nada.
O custo do prompt, honestamente
O prompt desta execução era grande porque o fluxo de trabalho o exigia. Instruções, definições de competências, definições de ferramentas, a tarefa e espaço para resultados de ferramentas acumulam-se, e não tenho interesse em remover competências ou ligações MCP para fazer um número parecer melhor. Um benchmark construído sobre um fluxo de trabalho mutilado não descreve um agente funcional.
Por isso, compare as categorias de custo honestamente, em vez de as fundir.
Os planos na nuvem podem faturar tokens de entrada, tokens de saída e entradas em cache de forma diferente. O termo de entrada sem cache é aproximadamente os tokens de entrada divididos por um milhão, multiplicados pelo preço de entrada do fornecedor por milhão. A faturação da saída e quaisquer descontos de cache dependem do fornecedor e do plano. A faturação efetiva depende, portanto, do fornecedor e do nível de preços, e não inventarei um valor em dólares para isso.
A inferência local elimina uma cobrança de API por token para esse modelo local. Não elimina as cobranças por ferramentas pagas ou serviços remotos, e não é gratuita. Os custos são o hardware, a memória e a capacidade de VRAM, o consumo de energia, a manutenção da configuração, o tempo de relógio que se passa à espera e a revisão humana do resultado. Esses custos são reais e não diminuem porque a inferência é local.
Um aspeto que se perde: a inferência local não torna as chamadas MCP remotas locais ou offline. As minhas ferramentas continuam a alcançar serviços remotos através da rede. O trabalho que sai da minha máquina é o tráfego das ferramentas, e o modelo que decide o que chamar constitui apenas uma parte da exposição.
Mantenha também a capacidade de contexto de 128K separada dos 66 170 tokens processados. A primeira é uma definição e o segundo é o que este turno enviou efetivamente. Nenhum dos dois equivale aos tokens faturáveis, nem ao custo de conclusão da tarefa.
O que esta execução mostra e o que não mostra
O resultado observado foi modesto e real: a sonda da competência em direto foi concluída contra o meu servidor de operações, o Kilo produziu um relatório e o relatório retornou com evidência para revisão humana. A sonda e a resposta terminaram. Só isso não prova que todas as instruções da competência tenham sido seguidas nem que todas as conclusões estejam corretas.
É esse o critério que me interessa realmente. Conclusão e correção, não velocidade. Esperar sete minutos e meio é um resultado aceitável quando o agente segue a sua competência, chama as ferramentas certas e devolve algo que possa ser revisto. Uma resposta inacabada não tem valor para este fluxo de trabalho.
Isso não significa que esta configuração seja, em geral, fiável, que corresponda a um modelo de fronteira na nuvem nem que os tempos aqui apresentados permitam prever os seus. Uma execução é uma execução. E um gráfico do tempo de processamento do prompt mede o custo de alimentar o modelo, não a qualidade daquilo que ele produziu. A conclusão, a qualidade do resultado e o custo da revisão determinam se vale a pena executar o fluxo de trabalho.
Se está a executar trabalho de agentes localmente, qual é o seu orçamento de processamento de prompts e como decide se um turno lento compensa a espera?
Nota sobre a evidência: Estes números provêm da execução local instrumentada de um único utilizador a 31 de outubro de 2026, com tempos aproximados num fluxo de trabalho real. Não constituem um benchmark padronizado, uma comparação controlada entre Ollama e llama.cpp nem uma comparação de desempenho ou custo entre nuvem e execução local.