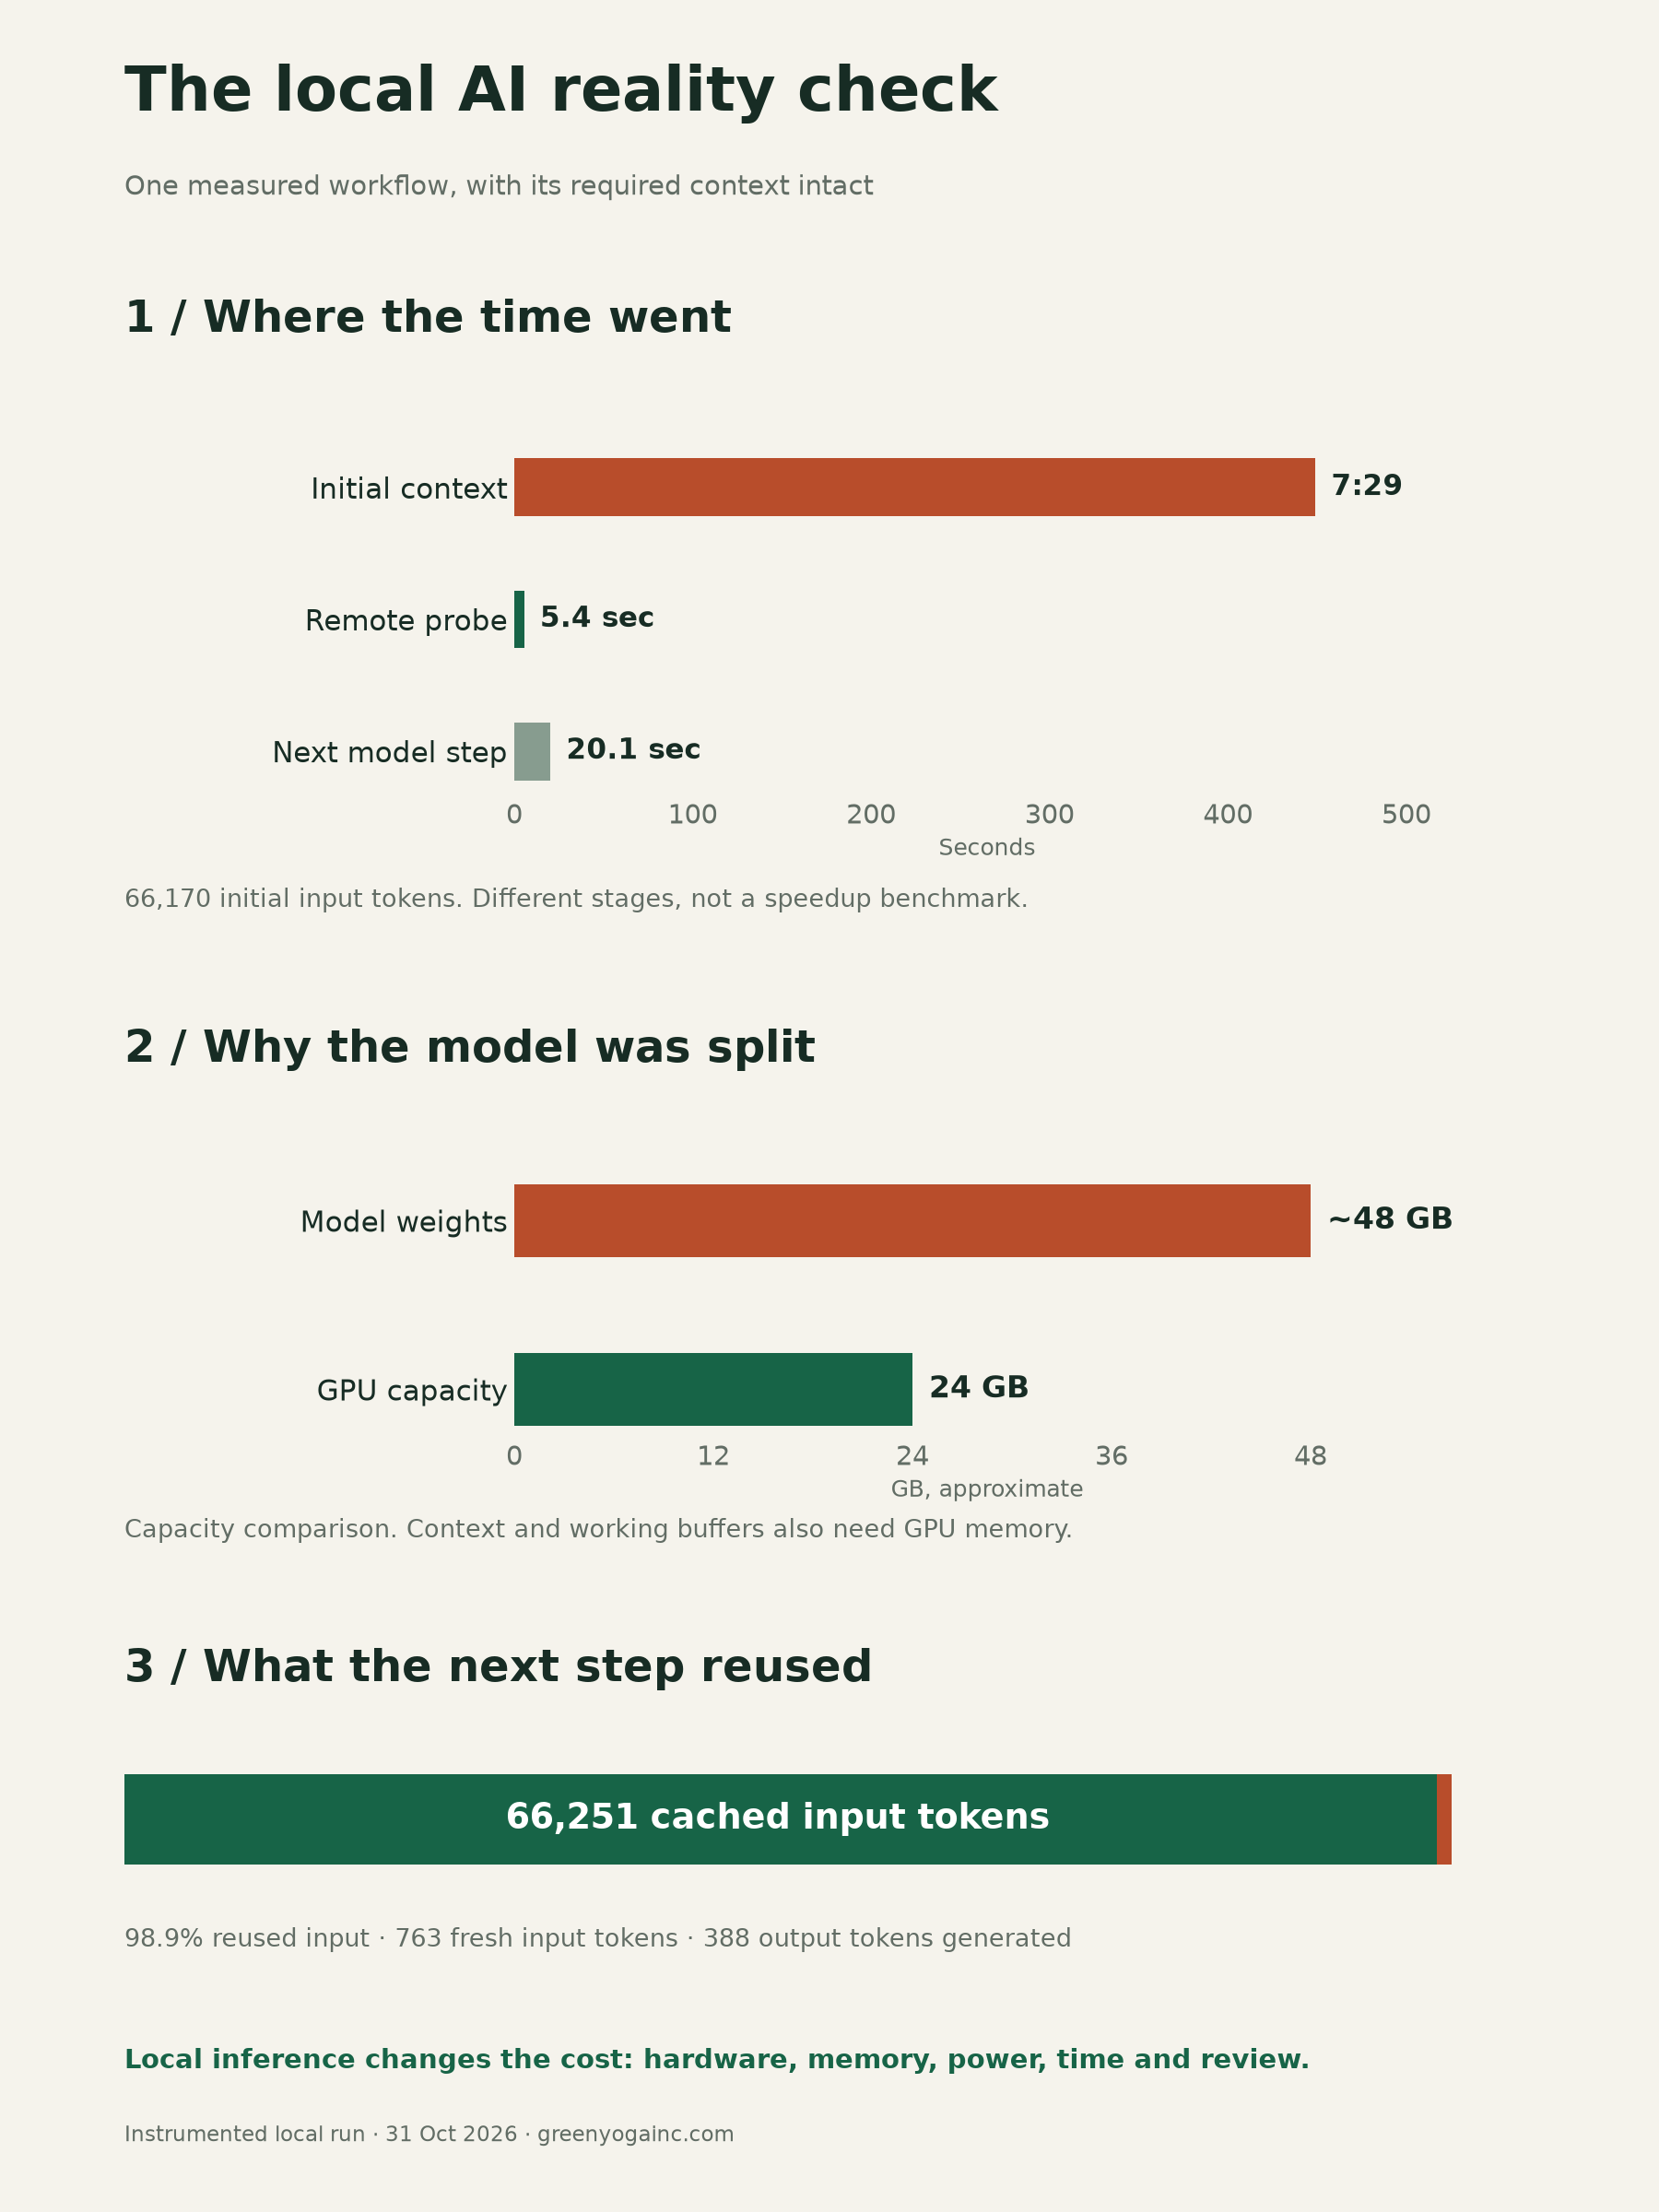
ツール呼び出しには5.4秒かかりました。それに必要なコンテキストの処理には7分29秒かかりました。
これが、私のローカルエージェントのワークフローを計測した1回の実行における内訳です。運用サーバーに対してログヘルスのワークフローを実行したところ、遠隔プローブ自体は5.428秒で正常に終了しました。そのプローブが実行される前に、同じターンでは必要なコンテキスト66,170入力トークンの処理に約7分29秒かかりました。速かったのはツールです。遅かったのは、ツールを呼び出す前にワークフローが必要としたすべてです。
有用なクラウドエージェントには、モデルの応答だけではなく、その周囲にあるワークフローも含まれます。そこには、作業の進め方を示すスキル、ツールやサービスを利用可能にするMCP接続、操作できる対象を決める権限、そして実際に作業を実行するブラウザーやシェルがあります。これをローカルで再現するには、チャット画面をモデルAPIにつなぐだけでは足りません。システム全体を再現する必要があります。
製品なのはエンドポイントではなくワークフロー
この用語のうち2つは、明確に定義しておく価値があります。難しい部分のほとんどはモデルではなく、ここにあるからです。
MCP(Model Context Protocol)は、エージェントホストがツールやサービスをモデルに公開するための仕組みです。各MCPサーバーはモデルが呼び出せるツールのカタログを公開し、そのツールの背後には、ファイル、リポジトリー、ブラウザー、データベース、遠隔サービスなどの実際の機能があります。ホストはすべての呼び出しを仲介し、権限もそこで適用されます。
スキルはワークフローの指示です。特定の種類の作業をどのように進めるか、どのツールを使い、何をどの順番で集め、出力に何を含めるべきかを示します。モデルが従う手順を提供しますが、モデルが手順を飛ばすこともあり、検証が必要です。
したがって重要なのは、ホスト、モデル、ランタイム、権限、ツール接続を合わせたシステムです。ホストは利用者が操作するアプリケーションで、私の場合はKilo Desktop、VS Code内のKilo、AnythingLLMです。ランタイムはモデルを提供し、モデルは推論を行います。スキルとMCP接続が、実行可能な作業を決めます。推論エンドポイントだけでは、エージェントホスト用のスキル、接続、権限は設定されません。
私が実行している環境
私のサービングスタックは、OpenAI互換のllama.cppサーバー(CUDA、ビルドb11852)で、Qwen 3 Coder Next(Q4_K_M)を実行しています。モデルメタデータによると、48層全体で総パラメーター数は79.67 billionで、量子化済み重みは約48 GBを占めます。マシンは、VRAM 24 GBのRTX 4090が1台、物理コア12個・24スレッドのRyzen 9 3900X、システムRAM 128 GBです。設定されたコンテキスト容量は131,072トークンで、最大応答長は8,192トークンです。
Qwen 3 Coder Nextはmixture-of-expertsモデルです。つまり、多数の独立したエキスパート重みセットを保持し、各トークンでその一部だけを活性化します。そのため、各トークンの計算で触れる重みは一部だけでも、保存する重みは大容量になります。このハードウェア構成を決めるうえでは、保存する重みのサイズが重要です。量子化後でも約48 GBあります。
モデルがGPUに収まらない理由
量子化済み重みが約48 GBであるのに対してVRAMは24 GBしかないため、これはチューニングの問題ではなく、単純な容量の問題です。Q4_K_M量子化は精度と品質を引き換えに重みの保存容量を減らしますが、このモデルを24 GBに収めることはできません。特に、コンテキストとランタイムのバッファにもVRAMが必要です。
解決策は配置を分割することです。48層のうち最初の32層のエキスパート重みをCPU/システムRAM側に割り当て、他のテンソルはGPUに置き、GPUのエキスパートキャッシュには上限を設けます。正確に言えば、これは32層全体をCPUだけで実行するという意味ではありません。mixture-of-expertsモデルでは各層にエキスパート重みが含まれており、最初の32層にあるエキスパート重みがシステムRAMに置かれます。
これに加えて、1,024 MiBのエキスパートGPUキャッシュ、Q8 KVキャッシュ、Flash Attentionを使っています。モデルの重みはGPUメモリ使用量の一部にすぎません。ランタイムには作業バッファと、一般にKVキャッシュと呼ばれるアテンション状態も必要です。Q8は、対応するキャッシュテンソルの保存精度を制御します。1 GiBのエキスパートキャッシュとFlash Attentionも、メモリと計算のトレードオフです。この実行では、それぞれの効果は個別に測定していません。
それぞれの要素を採用した理由
これらは1台のマシンと1つのワークロードに対する実用的な選択であり、ベンチマークによって最適性が証明されたものではありません。
| 選択 | 理由 | 条件・留意点 |
|---|---|---|
| llama.cppランタイム | 量子化とレイヤー配置を明示的に制御でき、エージェントホストが利用できるOpenAI互換APIを提供する | モデルではなくランタイムであり、変更しても同じモデルが賢くなるわけではない |
| コーディング向けMoEモデル | チャットのデモではなく、実際のタスクとツールのワークロードを支援するための試み | 最先端のクラウドモデルと同等であるとは証明されておらず、以前のローカル実行では人による修正が必要だった |
| Q4_K_M量子化 | ハイブリッド配置が可能になるほど重みの保存容量を減らす | 無条件の利点ではなく、精度と品質のトレードオフ |
| CPUとGPUへの分割配置 | VRAMには限りがあり、重みがその容量を超える | 48層のうち最初の32層のエキスパート重みはシステムRAMに置き、残りはGPUで実行する |
| 128Kコンテキスト上限 | 指示、スキルとツールの定義、タスク入力、ツール結果、出力のための余裕を確保する | 1ターンごとの必要量ではなく、設定された容量 |
| 同時リクエスト1件、CPUスレッド12本 | 利用可能なRAMと物理コアに対してメモリ需要を抑える | 他のワークロードで最適だとは実証されていない |
| Windowsネイティブでのサービング | WSL VMのRAM上限32 GBと、Windowsマウントのファイルを介したモデル読み込みの手間を避けた | Kilo独自のLinux運用コマンドは引き続きWSL内で実行される |
1回の実行で実際に起きたこと
| 段階 | 所要時間 | 詳細 |
|---|---|---|
| 入力とコンテキストの処理 | 448.92 s(7分29秒) | 初期入力66,170トークン、実効入力速度は約147トークン/秒 |
| 遠隔ログヘルスプローブ | 5.428 s | 終了コード0、私の運用サーバーに対する実行 |
| フォローアップのモデル応答 | 20.1 s | 入力66,251トークンを再利用、新規入力763トークン、出力388トークン、再利用率約98.9% |
これらは1回の実行における3つの異なる段階であり、同条件での比較ではありません。448.92秒は、1つのワークフローで1回観測された、大規模なコンテキストのコールド処理時間です。5.428秒は遠隔プローブの所要時間です。20.1秒は、ツールから結果が返った後の2回目のモデル処理です。449秒と20.1秒を同じタスクの高速化として捉えるのは誤りです。処理内容が異なるうえ、2回目の処理ではプレフィックスがすでにキャッシュされていたからです。
再利用はどこから来たか
フォローアップ処理では入力66,251トークンを再利用し、新規入力763トークンを処理しました。再利用率は約98.9%です。ここでは混同されやすい2つの仕組みを分けて説明します。KVキャッシュはアテンション状態を保存するため、生成の各ステップで以前のトークンを同じように毎回再計算する必要がありません。Q8は保存精度の選択です。プレフィックス再利用はエンジンの動作です。リクエストの先頭部分がすでに処理した内容と一致するとエンジンが判断し、その部分の再処理を省きました。どちらもモデルの重みを小さくするものではなく、クラウド請求の割引でもありません。クラウドプロバイダーの入力キャッシュに関する課金計算は、独自のルールと料金体系を持つ別の仕組みです。
可用性は別の問題
2026年10月31日、私のKilo Desktopセッションはスピナー表示のまま止まったため、停止したセッションの調査を依頼しました。原因はモデルの品質、コンテキストサイズ、ツールエラーではありません。ローカルのモデルサーバーが停止していました。Kiloは再試行を繰り返し、ECONNREFUSEDを受け取っていましたが、スピナー表示からは原因が分かりませんでした。
サーバーを起動すると、既存のセッションは復旧しました。コンテキストを破棄する必要はなく、作業をやり直す必要もありませんでした。恒久的な対策は、オンデマンドのランチャーです。サーバーを起動し、準備完了を待ってからKiloを開きます。Windowsへのサインイン時に自動起動するものは追加しませんでした。対話的にも使うマシンなので、それが私の望む動作でした。llama.cppとQwenの設定自体はこの出来事より前から整っていました。変わったのはサーバーの起動方法であり、モデルの提供方法ではありません。
先ほどの計測とは逆の教訓になるため、これは触れておく価値があります。利用できないサーバー上の高速なモデルは、何も生み出しません。
プロンプトコストを正直に考える
この実行のプロンプトが大きかったのは、ワークフローがそれを必要としたからです。指示、スキル定義、ツール定義、タスク、ツール結果のための余地を合計すると、大きな量になります。数値を良く見せるためにスキルやMCP接続を削るつもりはありません。機能を削ったワークフローに基づくベンチマークは、実際に動作するエージェントを表しません。
したがって、コストの項目をひとまとめにせず、正直に比較しましょう。
クラウドプランでは、入力トークン、出力トークン、キャッシュ済み入力を異なる方法で課金することがあります。キャッシュされていない入力の料金は、おおよそ入力トークン数を1,000,000で割り、プロバイダーの100万トークン当たりの入力料金を掛けた額です。出力料金とキャッシュ割引は、プロバイダーとプランによって異なります。実際の請求額は利用するプロバイダーと料金プランによって変わるため、根拠のないドル金額を作り上げるつもりはありません。
ローカル推論では、そのローカルモデルに対するトークン単位のAPI料金は発生しません。ただし、有料ツールや遠隔サービスの料金は残りますし、無料になるわけでもありません。費用には、ハードウェア、メモリとVRAMの容量、電力消費、環境の保守、待ち時間に費やす実時間、出力の人手によるレビューが含まれます。これらは実際のコストであり、推論をローカルで行うからといって小さくなるわけではありません。
見落とされがちな点が1つあります。ローカル推論にしても、遠隔MCP呼び出しがローカルまたはオフラインになるわけではありません。私のツールは引き続きネットワーク経由で遠隔サービスに接続します。マシンの外に出るのはツール通信であり、呼び出すものを決めるモデルは、外部への情報露出の一部にすぎません。
また、コンテキスト容量128Kと、処理された66,170トークンを区別してください。前者は設定値、後者はこのターンで実際に送信した量です。どちらも課金対象のトークン数と同じではなく、タスク完了コストとも同じではありません。
この実行が示すこと、示さないこと
観測された成果は控えめですが、確かなものでした。実環境でのスキルプローブは私の運用サーバーに対して完了し、Kiloはレポートを作成し、人間が確認できる証拠とともに返しました。プローブと応答は完了しました。ただし、それだけで、すべてのスキルの指示に従ったことや、すべての結論が正しかったことが証明されるわけではありません。
私が実際に重視する基準はこれです。速度ではなく、完了と正確さです。エージェントがスキルに従い、適切なツールを呼び出し、レビュー可能なものを返すなら、7分半待つことは許容できます。このワークフローでは、未完成の回答に価値はありません。
このことから、この構成が一般に信頼できること、最先端のクラウドモデルと同等であること、あるいはここでの計測があなたの結果を予測することは導けません。1回の実行は、あくまで1回の実行です。また、プロンプト処理時間のグラフが示すのはモデルに入力を与えるコストであって、生成物の品質ではありません。ワークフローを実行する価値があるかどうかは、完了、出力品質、レビューコストによって決まります。
ローカルでエージェントを動かしている方は、プロンプト処理にどれほどの時間をかけ、遅いターンを待つ価値があるかをどのように判断していますか?
根拠に関する注記: これらの数値は、2026年10月31日に1人のユーザーが、1つの実際のワークフローで行った単一の計測付きローカル実行から得た概算の時間です。標準化されたベンチマークでも、Ollamaとllama.cppを統制条件下で比較したものでも、クラウドとローカルの性能またはコストを比較したものでもありません。