Una chiamata a uno strumento ha richiesto 5,4 secondi. L'elaborazione del contesto necessario ha richiesto 7 minuti e 29 secondi.
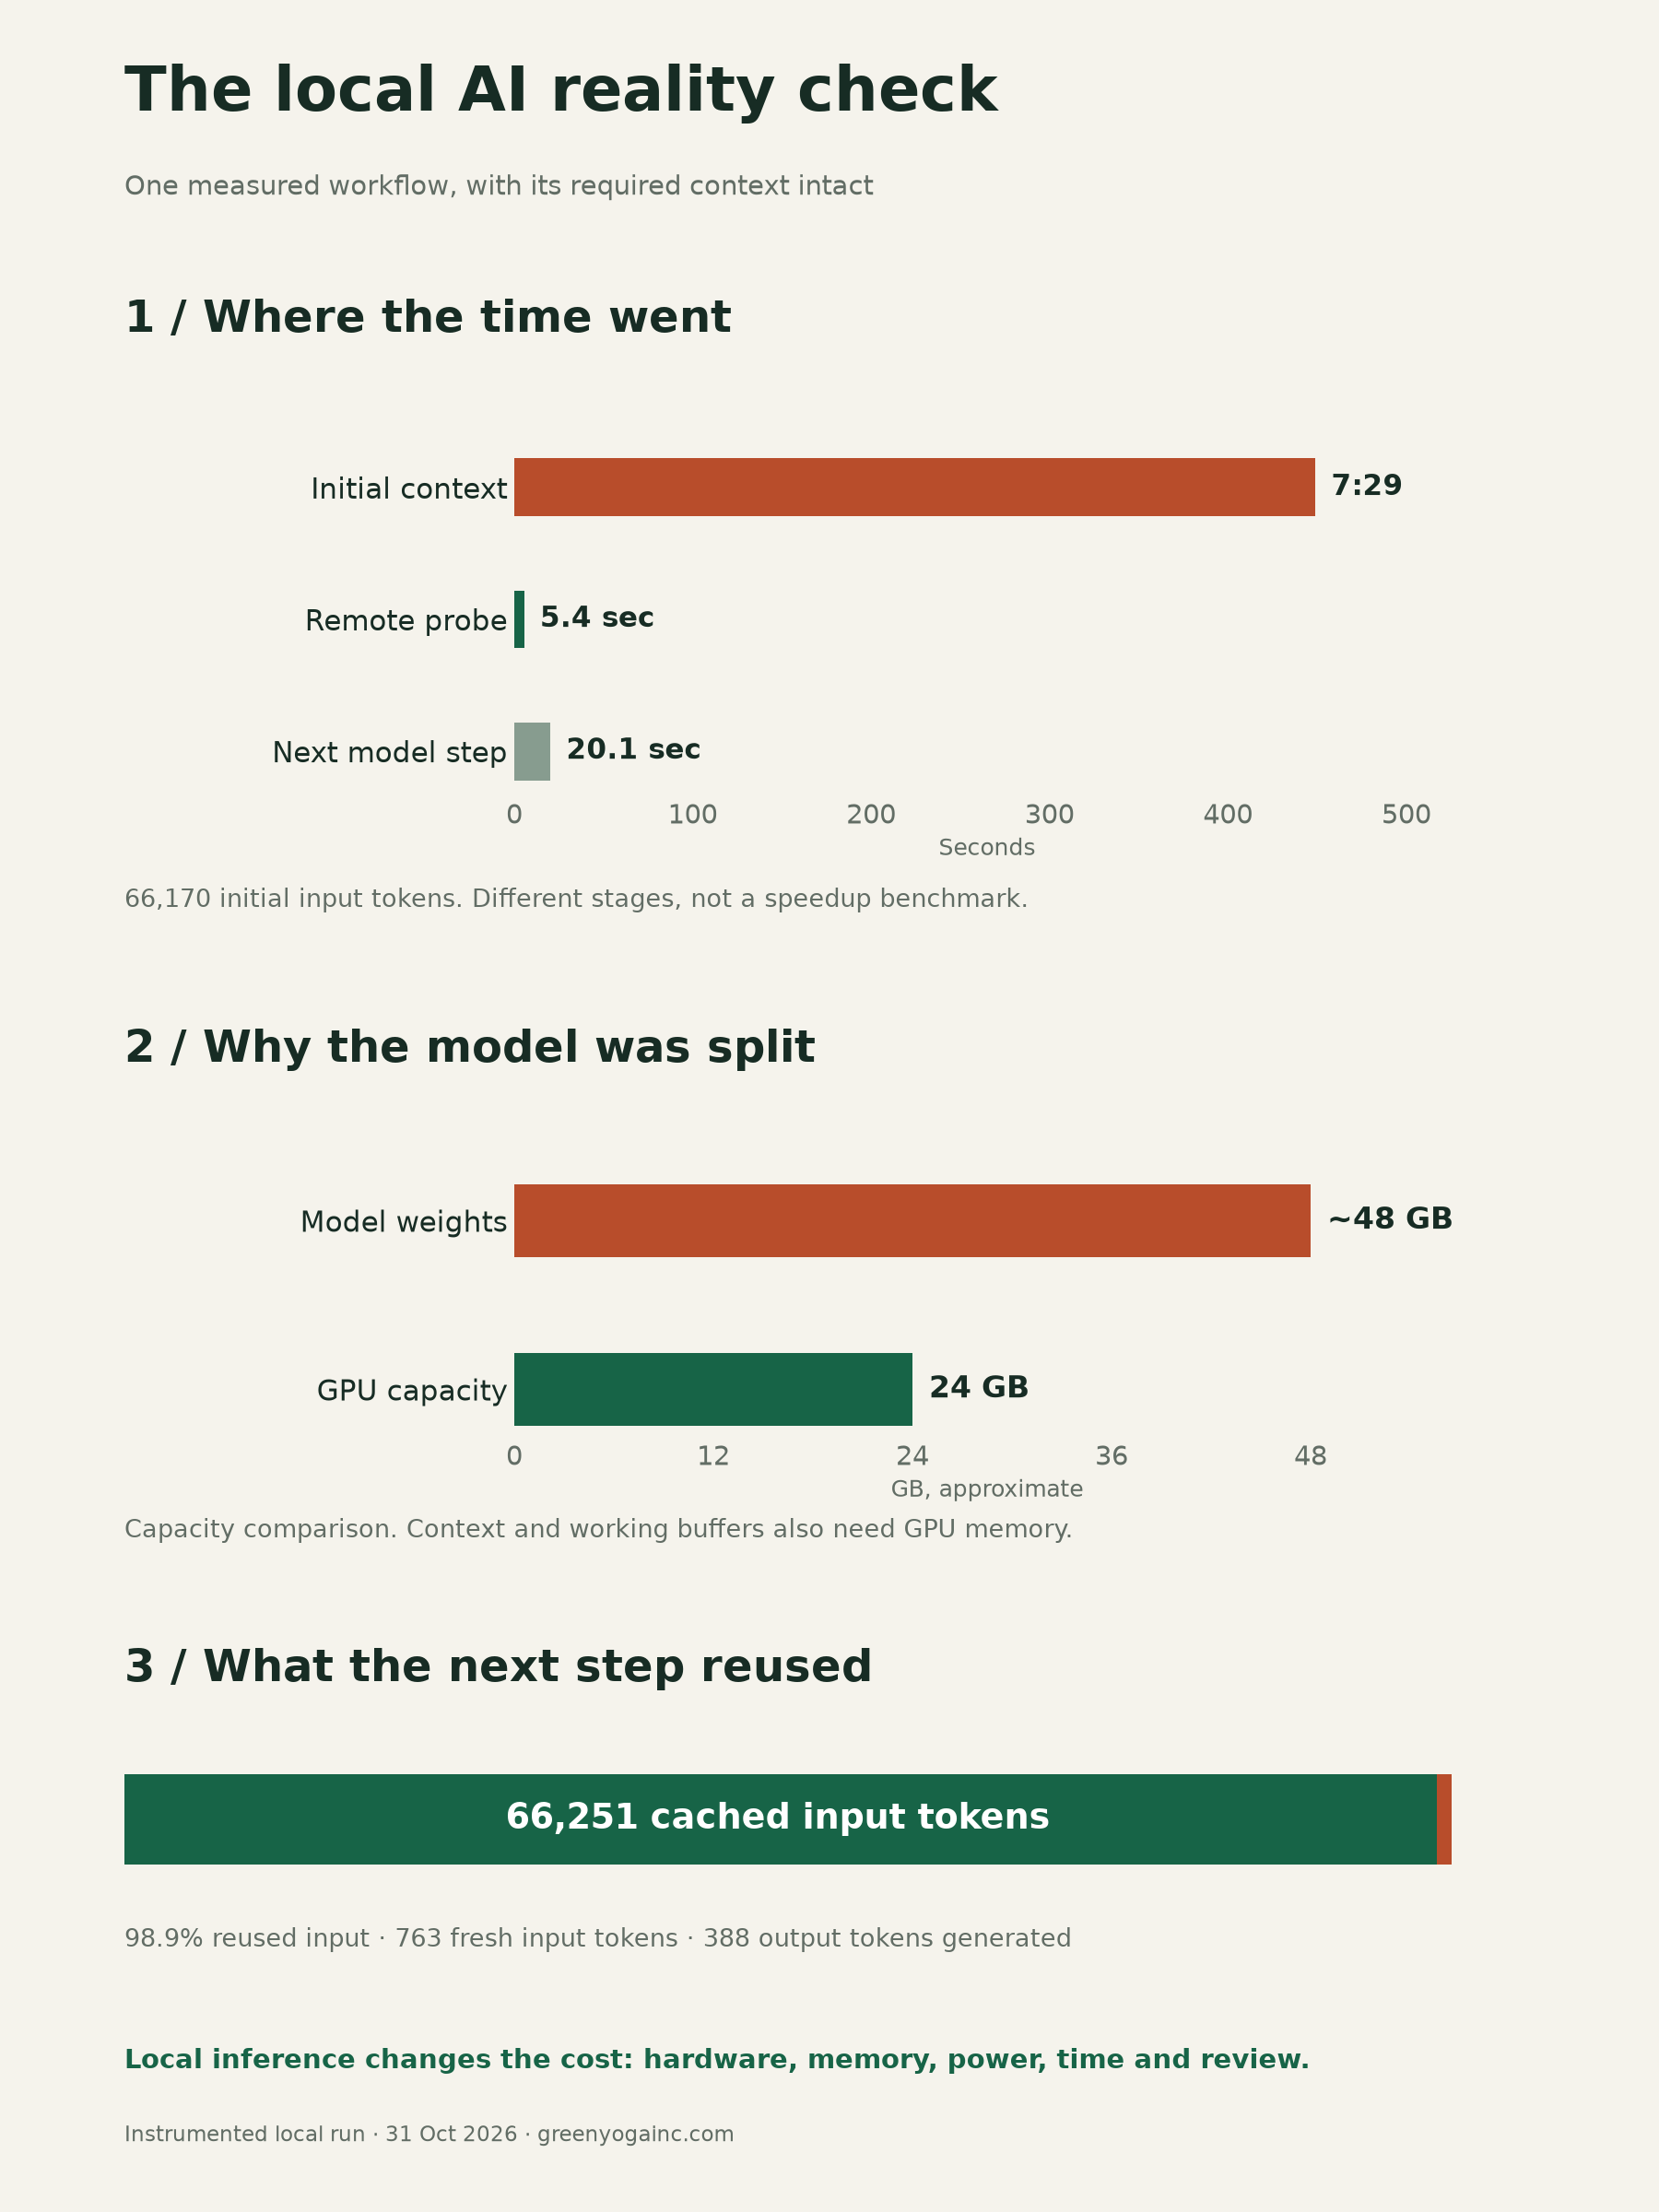
È stata questa la ripartizione in un'esecuzione strumentata del mio flusso di lavoro con agente locale. In un'esecuzione di un flusso di lavoro per verificare lo stato dei log sul mio server operativo, la sonda remota stessa ha richiesto 5,428 secondi ed è terminata correttamente. Prima che la sonda potesse essere eseguita, lo stesso turno ha impiegato circa 7 minuti e 29 secondi per elaborare 66,170 token di input di contesto necessari. La parte veloce è stata lo strumento. La parte lenta è stata tutto ciò che il flusso di lavoro richiedeva prima di poter richiamare lo strumento.
Un agente cloud utile comprende più della risposta del modello. Attorno al modello si trova un flusso di lavoro: le competenze che indicano come svolgere un'attività, le connessioni MCP che espongono strumenti e servizi, le autorizzazioni che determinano ciò che può essere modificato e il browser o la shell che esegue effettivamente il lavoro. Riprodurlo localmente significa riprodurre l'intero sistema, non puntare una finestra di chat a un'API di modelli.
Il flusso di lavoro è il prodotto, non l'endpoint
Vale la pena definire in modo semplice due elementi di questo vocabolario, perché la maggior parte della difficoltà risiede qui e non nel modello.
MCP, il Model Context Protocol, è il modo in cui un host per agenti espone strumenti e servizi a un modello. Ogni server MCP pubblica un catalogo di strumenti che il modello può richiamare e dietro questi strumenti si trovano le capacità reali: file, repository, browser, database e servizi remoti. L'host media ogni chiamata ed è sempre lo stesso punto in cui vengono applicate le autorizzazioni.
Le competenze sono istruzioni di flusso di lavoro. Una competenza indica come svolgere un tipo specifico di attività: quali strumenti usare, cosa raccogliere, in quale ordine e cosa deve contenere il risultato. Fornisce al modello una procedura da seguire, anche se il modello può comunque saltare dei passaggi e richiedere verifiche.
Il sistema che conta è quindi costituito insieme da host, modello, runtime, autorizzazioni e connessioni agli strumenti. L'host è l'applicazione con cui interagisco, nel mio caso Kilo Desktop, Kilo in VS Code e AnythingLLM. Il runtime serve il modello. Il modello esegue il ragionamento. Le competenze e le connessioni MCP determinano quali attività sono persino possibili. Un endpoint di inferenza da solo non configura tali competenze, connessioni o autorizzazioni per l'host dell'agente.
Che cosa sto usando
La mia pila di serving è un server llama.cpp compatibile con OpenAI (CUDA, build b11852) che esegue Qwen 3 Coder Next (Q4_K_M). I metadati del modello indicano 79,67 miliardi di parametri totali su 48 livelli e i pesi quantizzati occupano circa 48 GB. La macchina è dotata di una RTX 4090 con 24 GB di VRAM, un Ryzen 9 3900X con 12 core fisici e 24 thread e 128 GB di RAM di sistema. La capacità di contesto configurata è di 131,072 token, con una risposta massima di 8,192 token.
Qwen 3 Coder Next è un modello a miscela di esperti. Ciò significa che memorizza molti insiemi separati di pesi esperti e ne attiva solo un sottoinsieme per token. I pesi memorizzati sono quindi voluminosi, anche se il calcolo per token ne coinvolge solo una frazione. Per questa decisione sull'hardware è importante la dimensione dei pesi memorizzati: circa 48 GB anche dopo la quantizzazione.
Perché il modello non entra nella GPU
Circa 48 GB di pesi quantizzati contro 24 GB di VRAM costituiscono un problema aritmetico, non di ottimizzazione. La quantizzazione Q4_K_M riduce lo spazio di archiviazione dei pesi stabilendo un compromesso tra precisione e qualità, ma non fa entrare questo modello in 24 GB, soprattutto quando anche contesto e buffer del runtime richiedono VRAM.
La soluzione è una collocazione distribuita. I pesi degli esperti dei primi 32 dei 48 livelli sono assegnati al lato CPU/RAM di sistema; gli altri tensori rimangono sulla GPU, con una cache GPU limitata per gli esperti. Per essere precisi, non si tratta di 32 livelli completi eseguiti soltanto sulla CPU: in un modello a miscela di esperti questi livelli contengono pesi esperti e sono proprio i pesi degli esperti di quei primi 32 livelli a risiedere nella RAM di sistema.
A ciò si affiancano: una cache GPU per esperti da 1,024 MiB, una cache KV Q8 e Flash Attention. I pesi del modello costituiscono solo una parte dell'uso della memoria GPU. Il runtime necessita inoltre di buffer di lavoro e dello stato di attenzione, spesso denominato cache KV. Q8 controlla la precisione di archiviazione dei tensori supportati nella cache. La cache per esperti da 1 GiB e Flash Attention rappresentano ulteriori compromessi tra memoria e calcolo; in questa esecuzione non è stata isolata il loro singolo contributo.
Perché ciascun elemento è presente
Queste sono scelte pratiche per una macchina e un carico di lavoro, non ottimali dimostrate da benchmark.
| Scelta | Motivazione | Qualificazione |
|---|---|---|
| Runtime llama.cpp | Espone controlli espliciti di quantizzazione e collocazione dei livelli e serve un'API compatibile con OpenAI che l'host dell'agente può utilizzare | È un runtime, non un modello; cambiarlo non rende più intelligente lo stesso modello |
| Modello MoE orientato alla programmazione | Un tentativo di supportare un carico di lavoro reale con attività e strumenti anziché una dimostrazione di chat | Non è stato dimostrato equivalente ai modelli cloud di frontiera; precedenti esecuzioni locali richiedevano ancora correzioni umane |
| Quantizzazione Q4_K_M | Riduce lo spazio di archiviazione dei pesi quanto basta per rendere praticabile la collocazione ibrida | È un compromesso tra precisione e qualità, non un vantaggio gratuito |
| Divisione tra CPU e GPU | La VRAM è limitata e i pesi la superano | I pesi degli esperti dei primi 32 dei 48 livelli risiedono nella RAM di sistema; il resto viene eseguito sulla GPU |
| Limite di contesto 128K | Spazio per istruzioni, definizioni di competenze e strumenti, input dell'attività, risultati degli strumenti e output | Una capacità configurata, non un requisito per ogni turno |
| Una richiesta simultanea, 12 thread CPU | Limita la richiesta di memoria rispetto alla RAM e ai core fisici disponibili | Non è stato dimostrato ottimale per altri carichi di lavoro |
| Serving nativo Windows | Ha evitato il limite di 32 GB di RAM della VM WSL e le difficoltà di caricamento del modello attraverso i file montati in Windows | I comandi operativi Linux di Kilo continuano a essere eseguiti all'interno di WSL |
Che cosa ha fatto realmente un'esecuzione
| Fase | Durata | Dettaglio |
|---|---|---|
| Elaborazione dell'input e del contesto | 448.92 s (7 min 29 s) | 66,170 token di input iniziali, circa 147 token di input/sec effettivi |
| Sonda remota per verificare lo stato dei log | 5.428 s | Codice di uscita 0, sul mio server operativo |
| Risposta successiva del modello | 20.1 s | 66,251 token di input riutilizzati, 763 nuovi, 388 token di output, circa 98.9% riutilizzato |
Si tratta di tre fasi diverse di un'unica esecuzione, non di confronti omogenei. I 448.92 secondi corrispondono all'elaborazione a freddo di un contesto di grandi dimensioni, osservata una sola volta in un flusso di lavoro. I 5.428 secondi sono il tempo impiegato dalla sonda remota per svolgere il proprio lavoro. I 20.1 secondi sono una seconda fase del modello dopo il ritorno dello strumento. Interpretare 449 secondi rispetto a 20.1 secondi come un'accelerazione della stessa attività sarebbe errato, perché il lavoro era diverso e la seconda fase ha ereditato un prefisso già elaborato.
Provenienza del riutilizzo
Questa fase successiva ha riutilizzato 66,251 token di input e ne ha elaborati 763 nuovi, per circa il 98.9% di riutilizzo. È facile confondere due meccanismi diversi, quindi conviene separarli. Il caching KV memorizza lo stato di attenzione, così che i token precedenti non debbano essere ricalcolati allo stesso modo a ogni fase di generazione; Q8 è una scelta di precisione di archiviazione. Il riutilizzo del prefisso è un comportamento: il motore ha rilevato che l'inizio della richiesta corrispondeva a quanto già elaborato e ha saltato la rielaborazione di quella parte. Nessuno dei due meccanismi riduce i pesi del modello e nessuno è uno sconto sulla fatturazione cloud. La contabilizzazione della cache di input presso un provider cloud è un meccanismo separato, con regole e tariffe proprie.
La disponibilità è un problema separato
Il 31 ottobre 2026 la mia sessione di Kilo Desktop è rimasta visualizzando un indicatore di caricamento, così ho chiesto di indagare sulla sessione bloccata. La causa non era la qualità del modello, la dimensione del contesto o un errore dello strumento. Il server locale del modello era spento. Kilo ha continuato a riprovare e a ricevere ECONNREFUSED, mentre l'indicatore di caricamento non ha mai reso chiara la causa.
L'avvio del server ha ripristinato la sessione esistente. Non è stato necessario scartare il contesto né ripetere il lavoro. La correzione duratura è stato un avviatore su richiesta: avviare il server, attendere che fosse pronto e poi aprire Kilo. Non è stato aggiunto nulla all'accesso a Windows, cosa che preferivo su una macchina che uso anche in modo interattivo. La configurazione di llama.cpp e Qwen era già presente prima di questo episodio; l'incidente ha cambiato il modo di avviare il server, non il modo di servire il modello.
Vale la pena menzionarla perché rappresenta la lezione opposta rispetto ai tempi descritti sopra. Un modello veloce su un server non disponibile non produce nulla.
Il costo del prompt, in modo onesto
In questa esecuzione il prompt era di grandi dimensioni perché il flusso di lavoro lo richiedeva. Istruzioni, definizioni delle competenze, definizioni degli strumenti, attività e spazio per i risultati degli strumenti si sommano, e non ho alcun interesse a eliminare competenze o connessioni MCP per far sembrare migliore un numero. Un benchmark costruito su un flusso di lavoro svuotato non descrive un agente funzionante.
È quindi giusto confrontare onestamente le categorie di costo senza accorparle.
I piani cloud possono fatturare in modo diverso token di input, token di output e input in cache. Il termine per l'input non in cache corrisponde all'incirca ai token di input divisi per un milione, moltiplicati per il prezzo del provider per token di input per milione. La fatturazione dell'output e gli eventuali sconti sulla cache dipendono dal provider e dal piano. La fatturazione effettiva dipende quindi dal provider e dalla fascia di prezzo utilizzati e non inventerò una cifra in dollari.
L'inferenza locale elimina l'addebito API per token per quel modello locale. Non elimina gli addebiti per strumenti a pagamento o servizi remoti e non è gratuita. I costi consistono nell'hardware, nella capacità di memoria e VRAM, nel consumo elettrico, nella manutenzione della configurazione, nel tempo trascorso in attesa e nella revisione umana dell'output. Questi costi sono reali e non diminuiscono perché l'inferenza è locale.
Un aspetto che spesso si perde di vista: l'inferenza locale non rende locali né offline le chiamate MCP remote. I miei strumenti continuano a raggiungere servizi remoti attraverso la rete. Il lavoro che lascia la mia macchina è il traffico degli strumenti, mentre la decisione del modello su cosa richiamare costituisce solo una parte dell'esposizione.
Tenete inoltre distinti la capacità di contesto 128K e i 66,170 token elaborati. La prima è un'impostazione, la seconda è ciò che questo turno ha effettivamente inviato. Nessuna delle due equivale ai token fatturabili né al costo per completare l'attività.
Che cosa mostra e che cosa non mostra questa esecuzione
Il risultato osservato è stato modesto e reale: la sonda della competenza in tempo reale è stata completata sul mio server operativo, Kilo ha prodotto un rapporto e il rapporto è tornato con prove da far revisionare a una persona. La sonda e la risposta sono state completate. Questo da solo non dimostra che ogni istruzione della competenza sia stata seguita o che ogni conclusione sia corretta.
È questo il criterio che mi interessa davvero. Completamento e correttezza, non velocità. Attendere sette minuti e mezzo è un risultato accettabile quando l'agente segue la propria competenza, richiama gli strumenti giusti e restituisce qualcosa di verificabile. Una risposta incompleta non ha alcun valore per questo flusso di lavoro.
Non segue che questa configurazione sia generalmente affidabile, che corrisponda a un modello cloud di frontiera o che i tempi riportati qui consentano di prevedere quelli altrui. Un'esecuzione è un'esecuzione. E un grafico del tempo di elaborazione del prompt misura il costo di alimentazione del modello, non la qualità di ciò che ha prodotto. Il completamento, la qualità dell'output e il costo della revisione determinano se vale la pena eseguire il flusso di lavoro.
Se eseguite attività con un agente localmente, qual è il vostro budget di elaborazione dei prompt e come decidete se un turno lento vale la pena di attesa?
Nota sulle prove: Questi dati provengono da una singola esecuzione locale strumentata di un utente il 31 ottobre 2026, con tempi approssimativi su un flusso di lavoro reale. Non si tratta di un benchmark standardizzato, di un confronto controllato tra Ollama e llama.cpp né di un confronto delle prestazioni o dei costi tra cloud e locale.