Un appel d’outil a pris 5,4 secondes. Le traitement du contexte qu’il requérait a pris 7 minutes 29 secondes.
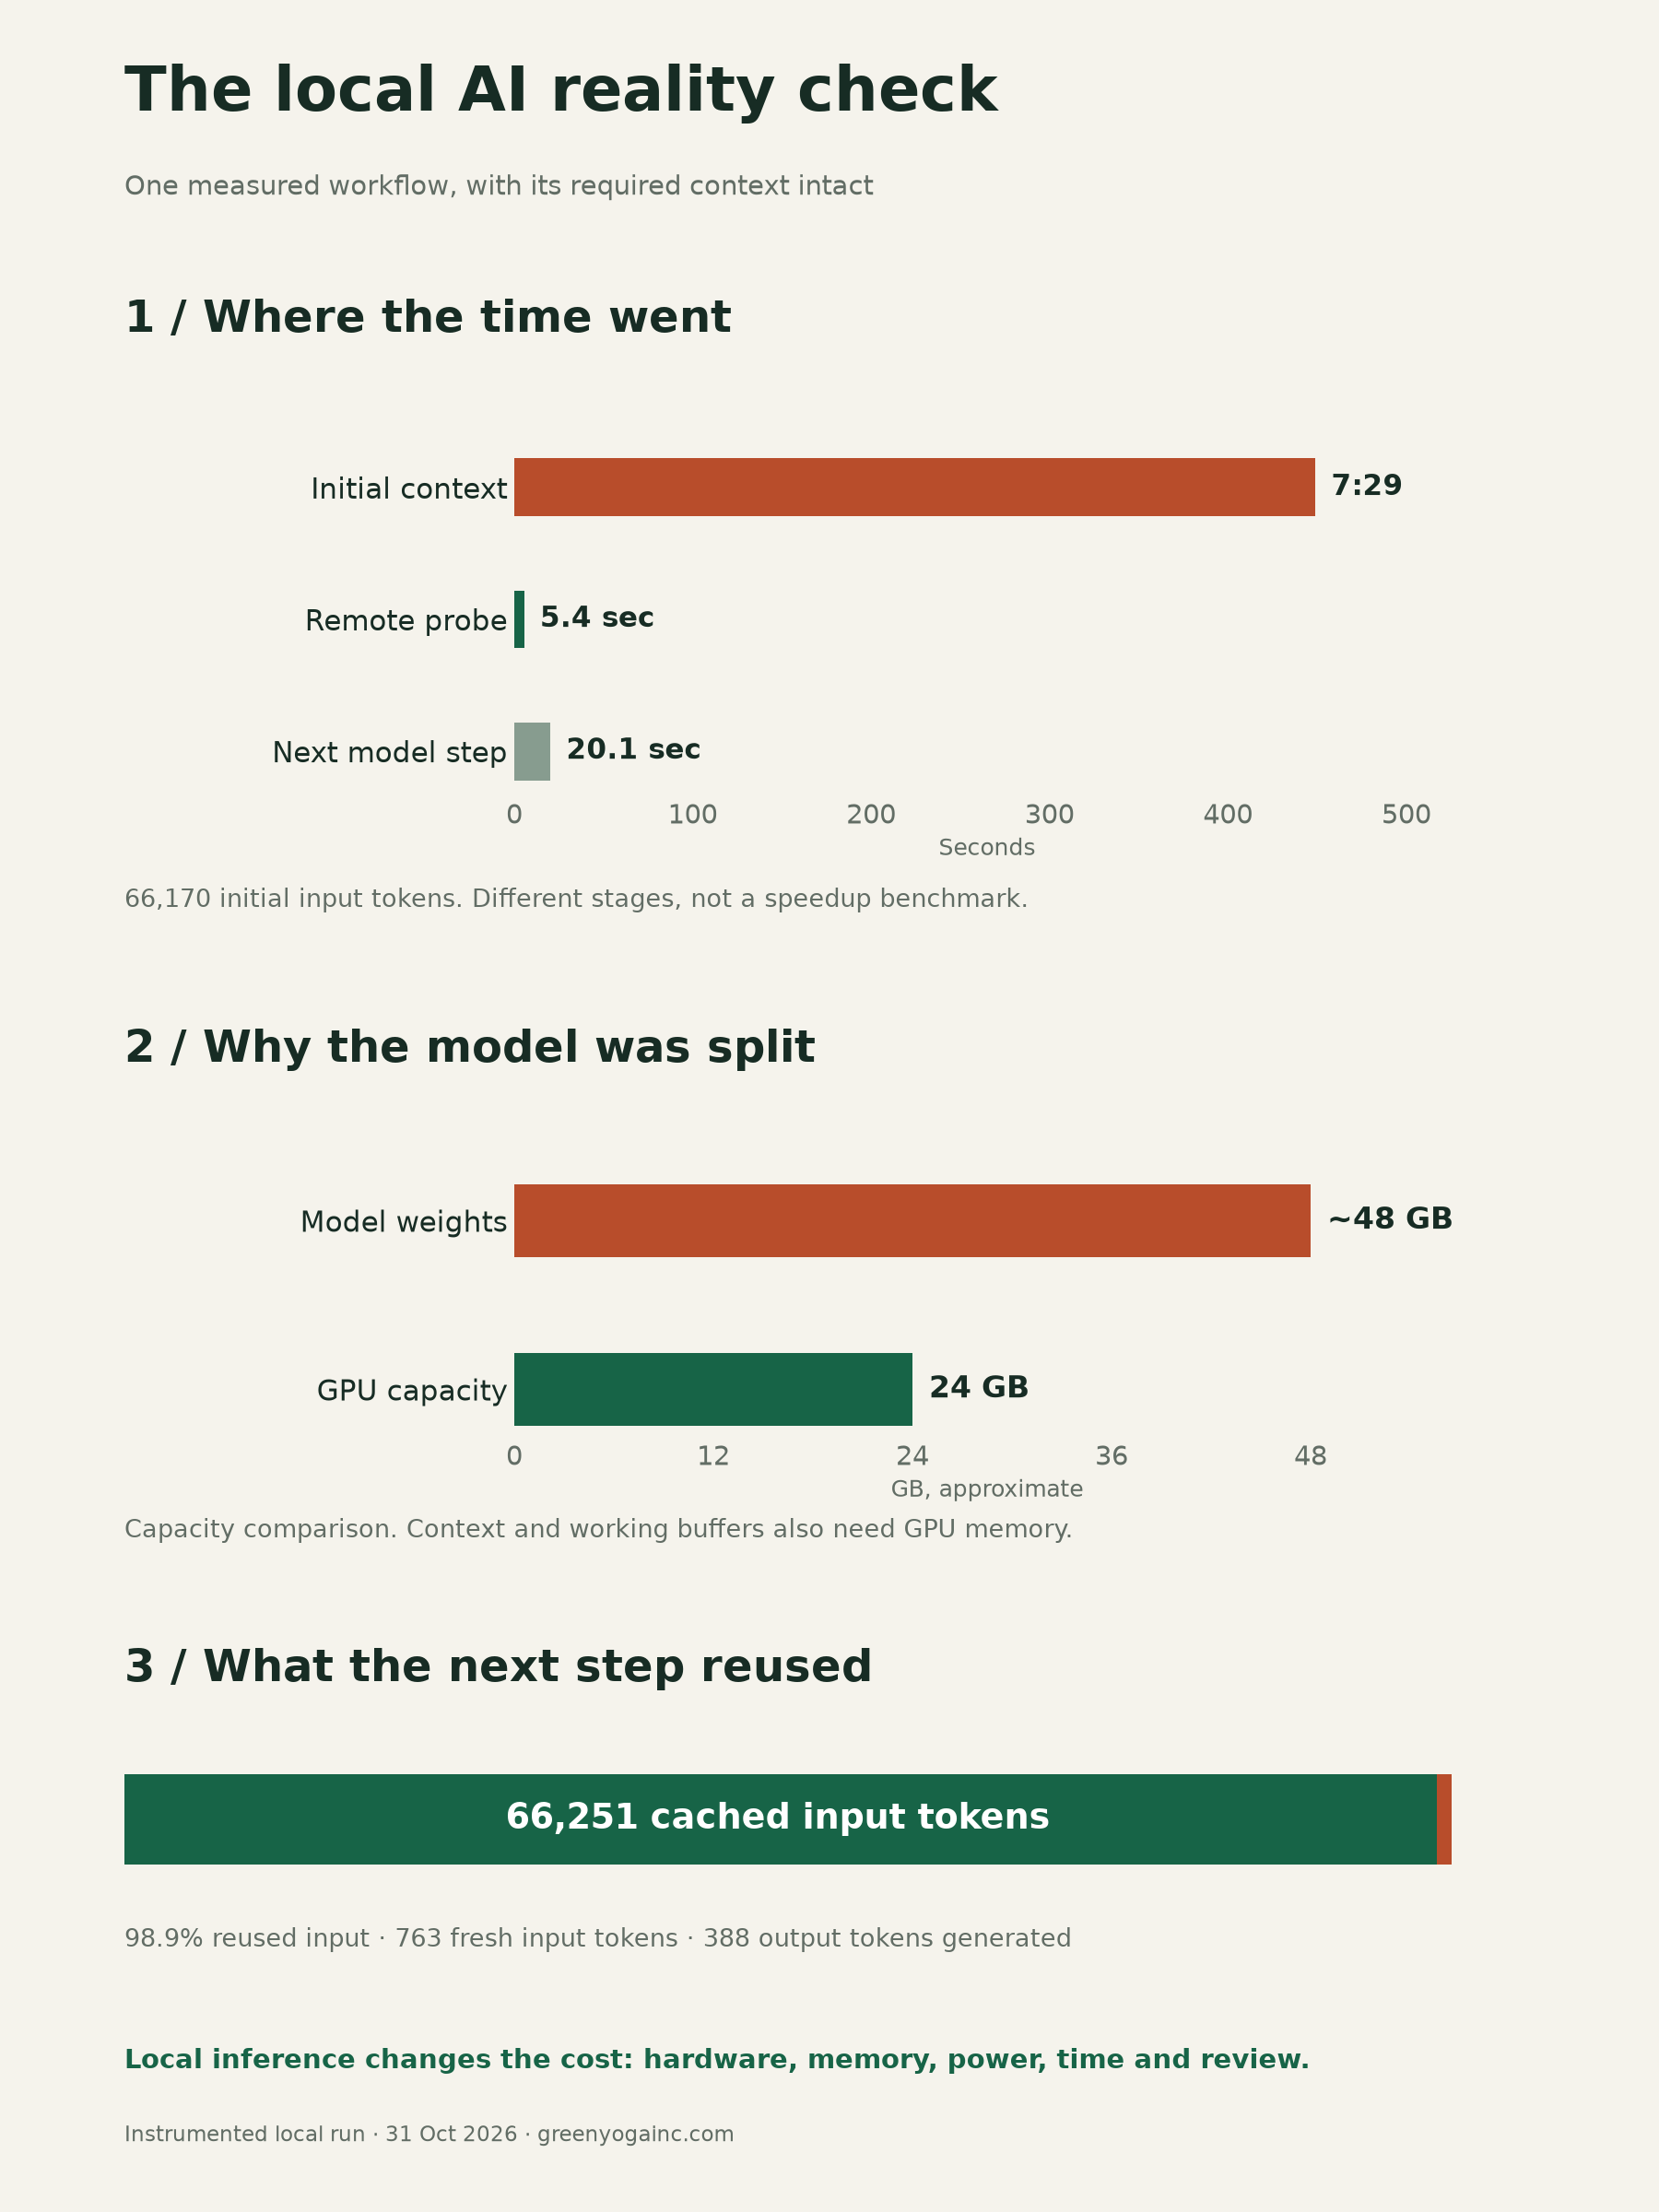
Tel était le partage du temps lors d’une seule exécution instrumentée de mon flux de travail d’agent local. Lors d’une exécution d’un flux de travail de contrôle de l’état des journaux sur mon serveur d’exploitation, la sonde distante elle-même a pris 5,428 secondes et s’est terminée sans erreur. Avant que cette sonde puisse être exécutée, le même tour de conversation a consacré environ 7 minutes 29 secondes au traitement de 66 170 jetons d’entrée de contexte requis. La partie rapide était l’outil. La partie lente comprenait tout ce dont le flux de travail avait besoin avant que l’outil puisse être appelé.
Un agent cloud utile ne se limite pas à la réponse du modèle. Un flux de travail l’entoure : les compétences qui indiquent comment effectuer une tâche, les connexions MCP qui exposent les outils et les services, les autorisations qui déterminent ce qui peut être modifié, et le navigateur ou l’interpréteur de commandes qui effectue réellement le travail. Reproduire cela localement signifie reproduire le système, et non simplement pointer une fenêtre de chat vers une API de modèle.
Le flux de travail est le produit, pas le point d’accès
Deux termes de ce vocabulaire méritent d’être définis clairement, car la majeure partie de la difficulté se situe ici, et non dans le modèle.
MCP, le Model Context Protocol, est le moyen par lequel un hôte d’agent expose des outils et des services à un modèle. Chaque serveur MCP publie un catalogue d’outils que le modèle peut appeler et, derrière ces outils, se trouvent les véritables capacités : fichiers, dépôts, navigateurs, bases de données et services distants. L’hôte médiatise chaque appel, ce qui est également l’endroit où les autorisations sont appliquées.
Les compétences sont des instructions de flux de travail. Une compétence indique comment effectuer un type de tâche particulier : quels outils utiliser, quelles informations recueillir, dans quel ordre et ce que la sortie doit contenir. Elle fournit au modèle une procédure à suivre, même si le modèle peut encore omettre des étapes et nécessite une vérification.
Le système qui compte est donc l’ensemble formé par l’hôte, le modèle, l’environnement d’exécution, les autorisations et les connexions aux outils. L’hôte est l’application avec laquelle vous interagissez, dans mon cas Kilo Desktop, Kilo dans VS Code et AnythingLLM. L’environnement d’exécution sert le modèle. Le modèle effectue le raisonnement. Les compétences et les connexions MCP déterminent les travaux qui sont même possibles. Un point d’accès d’inférence à lui seul ne configure ni ces compétences, ni ces connexions, ni ces autorisations pour l’hôte d’agent.
Ce que j’exécute
Ma pile de service est un serveur llama.cpp compatible avec OpenAI (CUDA, build b11852) exécutant Qwen 3 Coder Next (Q4_K_M). Les métadonnées du modèle indiquent 79,67 milliards de paramètres au total répartis sur 48 couches, et les poids quantifiés occupent environ 48 GB. La machine se compose d’une RTX 4090 avec 24 GB de VRAM, d’un Ryzen 9 3900X avec 12 cœurs physiques et 24 threads, et de 128 GB de RAM système. La capacité de contexte configurée est de 131 072 jetons, avec un maximum de 8 192 jetons par réponse.
Qwen 3 Coder Next est un modèle à mélange d’experts. Cela signifie qu’il stocke de nombreux ensembles distincts de poids d’experts et n’active qu’un sous-ensemble d’entre eux pour chaque jeton. Les poids stockés sont donc volumineux, même si le calcul par jeton n’en touche qu’une fraction. Pour cette décision matérielle, la taille des poids stockés est importante : environ 48 GB, même après quantification.
Pourquoi le modèle ne tient pas sur le GPU
Environ 48 GB de poids quantifiés face à 24 GB de VRAM constituent un problème arithmétique, et non un problème de réglage. La quantification Q4_K_M réduit le stockage des poids au prix d’un compromis entre précision et qualité, mais elle ne permet pas à ce modèle de tenir dans 24 GB, surtout lorsque le contexte et les tampons de l’environnement d’exécution nécessitent aussi de la VRAM.
La solution consiste à répartir le modèle. Les poids d’experts des 32 premières couches sur 48 sont affectés au côté CPU/RAM système ; les autres tenseurs restent sur le GPU, avec un cache d’experts GPU à taille limitée. Pour être précis, il ne s’agit pas de 32 couches complètes exécutées uniquement sur le CPU : dans un modèle à mélange d’experts, ces couches contiennent des poids d’experts, et ce sont les poids d’experts de ces 32 premières couches qui résident dans la RAM système.
En complément : un cache d’experts GPU de 1 024 MiB, un cache KV Q8 et Flash Attention. Les poids du modèle ne représentent qu’une partie de l’utilisation de la mémoire GPU. L’environnement d’exécution a également besoin de tampons de travail et d’un état d’attention, souvent appelé cache KV. Q8 contrôle la précision de stockage des tenseurs de cache pris en charge. Le cache d’experts de 1 GiB et Flash Attention constituent d’autres compromis mémoire/calcul ; leur contribution respective n’a pas été isolée lors de cette exécution.
Pourquoi chaque élément est présent
Il s’agit de choix pratiques pour une machine et une charge de travail, et non d’optimes prouvés par des tests de performance.
| Choix | Justification | Réserve |
|---|---|---|
| Environnement d’exécution llama.cpp | Expose des contrôles explicites de quantification et de placement des couches, et sert une API compatible avec OpenAI que l’hôte d’agent peut consommer | Un environnement d’exécution, pas un modèle ; le modifier ne rend pas le même modèle plus intelligent |
| Modèle MoE orienté programmation | Tente de prendre en charge une véritable charge de travail avec outils plutôt qu’une démonstration de chat | Il n’est pas prouvé égal aux modèles cloud de pointe ; les exécutions locales antérieures exigeaient encore des corrections humaines |
| Quantification Q4_K_M | Réduit suffisamment le stockage des poids pour rendre viable le placement hybride | Un compromis entre précision et qualité, pas un gain gratuit |
| Répartition CPU/GPU | La VRAM est limitée et les poids la dépassent | Les poids d’experts des 32 premières couches sur 48 résident dans la RAM système ; le reste s’exécute sur le GPU |
| Plafond de contexte de 128K | Marge pour les instructions, les définitions de compétences et d’outils, l’entrée de la tâche, les résultats des outils et la sortie | Une capacité configurée, pas une exigence par tour de conversation |
| Une requête simultanée, 12 threads CPU | Maîtrise la demande de mémoire par rapport à la RAM et aux cœurs physiques disponibles | Optimalité non démontrée pour les autres charges de travail |
| Service natif sous Windows | Évite la limite de 32 GB de RAM de la machine virtuelle WSL et les difficultés de chargement du modèle via les fichiers montés depuis Windows | Les propres commandes d’exploitation Linux de Kilo s’exécutent toujours dans WSL |
Ce qu’une exécution a réellement effectué
| Étape | Durée | Détail |
|---|---|---|
| Traitement de l’entrée et du contexte | 448,92 s (7 min 29 s) | 66 170 jetons d’entrée initiaux, environ 147 jetons d’entrée/s effectifs |
| Sonde distante de contrôle de l’état des journaux | 5,428 s | Code de sortie 0, sur mon serveur d’exploitation |
| Réponse suivante du modèle | 20,1 s | 66 251 jetons d’entrée réutilisés, 763 nouveaux, 388 jetons de sortie, environ 98,9 % réutilisés |
Il s’agit de trois étapes différentes d’une même exécution, et non de comparaisons équivalentes. Les 448,92 secondes correspondent au traitement à froid d’un contexte volumineux, observé une seule fois sur un seul flux de travail. Les 5,428 secondes correspondent à la sonde distante effectuant son travail. Les 20,1 secondes correspondent à une seconde étape du modèle après le retour de l’outil. Considérer les 449 secondes face aux 20,1 secondes comme une accélération de la même tâche serait erroné, car le travail était différent et la seconde étape a hérité d’un préfixe déjà chargé.
Provenance de la réutilisation
Cette étape suivante a réutilisé 66 251 jetons d’entrée et en a traité 763 nouveaux, soit environ 98,9 % réutilisés. Deux mécanismes différents sont faciles à confondre ici ; il convient donc de les distinguer. La mise en cache KV stocke l’état d’attention afin que les jetons précédents n’aient pas à être recalculés de la même manière à chaque étape de génération ; Q8 est un choix de précision de stockage. La réutilisation de préfixe est un comportement : le moteur a remarqué que le début de la requête correspondait à ce qu’il avait déjà traité et a sauté le retraitement de cette partie. Aucun des deux mécanismes ne réduit la taille des poids du modèle, et aucun ne constitue une remise cloud. La comptabilisation du cache d’entrée par un fournisseur cloud est un mécanisme distinct, soumis à ses propres règles et à ses propres tarifs.
La disponibilité est un problème distinct
Le 31 octobre 2026, ma session Kilo Desktop restait affichée sur un indicateur de chargement ; j’ai donc demandé que la session bloquée soit examinée. La cause n’était ni la qualité du modèle, ni la taille du contexte, ni une erreur d’outil. Le serveur de modèle local était arrêté. Kilo a continué à réessayer et à recevoir ECONNREFUSED, sans jamais rendre cette cause lisible.
Le démarrage du serveur a rétabli la session existante. Aucun contexte n’a dû être abandonné et aucun travail n’a dû être refait. La correction durable consistait à mettre en place un lanceur à la demande : démarrer le serveur, attendre qu’il soit prêt, puis ouvrir Kilo. Rien n’a été ajouté au démarrage de session de Windows, ce que je préférais sur une machine que j’utilise également de manière interactive. La configuration de llama.cpp et de Qwen était déjà en place avant cela ; l’incident a changé la manière de démarrer le serveur, pas la manière de servir le modèle.
Il convient de le signaler, car cette leçon est inverse à celle des durées ci-dessus. Un modèle rapide sur un serveur indisponible ne produit rien du tout.
Le coût de l’invite, honnêtement
L’invite utilisée lors de cette exécution était volumineuse parce que le flux de travail l’exigeait. Les instructions, les définitions de compétences et d’outils, la tâche et la place laissée aux résultats des outils s’additionnent, et je n’ai aucun intérêt à retirer des compétences ou des connexions MCP afin de rendre un chiffre plus favorable. Un test de performance fondé sur un flux de travail amputé ne décrit pas un agent opérationnel.
Il convient donc de comparer honnêtement les catégories de coûts, plutôt que de les fusionner.
Les offres cloud peuvent facturer différemment les jetons d’entrée, les jetons de sortie et les entrées mises en cache. Le terme correspondant aux entrées non mises en cache correspond approximativement aux jetons d’entrée divisés par un million, multipliés par le prix d’entrée du fournisseur par million. La facturation des sorties et les éventuelles remises liées au cache dépendent du fournisseur et de l’offre. La facturation réelle dépend donc du fournisseur et du palier tarifaire, et je ne vais pas inventer de montant en dollars.
L’inférence locale supprime les frais d’API par jeton pour ce modèle local. Elle ne supprime pas les frais des outils payants ou des services distants, et elle n’est pas gratuite. Les coûts comprennent le matériel, la capacité de mémoire et de VRAM, la consommation d’électricité, la maintenance de la configuration, le temps réel que vous consacrez à l’attente et la relecture humaine de la sortie. Ces coûts sont réels et ils ne diminuent pas parce que l’inférence est locale.
Un point est souvent perdu de vue : l’inférence locale ne rend ni les appels MCP distants locaux, ni hors ligne. Mes outils continuent d’atteindre des services distants par le réseau. Le travail qui quitte ma machine correspond au trafic des outils, et le modèle qui décide quoi appeler ne représente qu’une partie de l’exposition.
Il faut aussi distinguer la capacité de contexte de 128K des 66 170 jetons traités. La première est un paramètre ; la seconde correspond à ce que ce tour de conversation a effectivement envoyé. Ni l’un ni l’autre n’équivaut à des jetons facturables, ni à un coût de réalisation de la tâche.
Ce que cette exécution montre, et ce qu’elle ne montre pas
Le résultat observé était modeste mais réel : la sonde de compétence en direct s’est terminée correctement sur mon serveur d’exploitation, Kilo a produit un rapport et celui-ci est revenu accompagné de preuves à examiner par un humain. La sonde et la réponse se sont terminées. Cela ne prouve pas à lui seul que chaque instruction de compétence a été suivie ou que chaque conclusion était correcte.
C’est le critère auquel je tiens réellement : l’achèvement et la justesse, et non la vitesse. Attendre sept minutes et demie est un résultat acceptable lorsque l’agent suit sa compétence, appelle les bons outils et renvoie un résultat que l’on peut examiner. Une réponse inachevée n’a aucune valeur pour ce flux de travail.
Il n’en découle pas que cette configuration est généralement fiable, qu’elle est équivalente à un modèle cloud de pointe ou que les durées présentées ici permettent de prédire les vôtres. Une exécution ne représente qu’une exécution. Et un graphique du temps de traitement de l’invite mesure le coût de l’alimentation du modèle, et non la qualité de ce qu’il a produit. L’achèvement, la qualité de la sortie et le coût de la relecture déterminent si le flux de travail vaut la peine d’être exécuté.
Si vous exécutez des tâches d’agent localement, quel est votre budget de traitement des invites et comment décidez-vous si un tour de conversation lent mérite l’attente ?
Note sur les éléments probants : Ces chiffres proviennent de l’exécution locale instrumentée d’un seul utilisateur, le 31 octobre 2026, avec des durées approximatives sur un seul flux de travail réel. Ils ne constituent ni un test de performance standardisé, ni une comparaison contrôlée entre Ollama et llama.cpp, ni une comparaison des performances ou des coûts entre le cloud et l’exécution locale.