Ein Tool-Aufruf dauerte 5,4 Sekunden. Die Verarbeitung des dafür benötigten Kontexts dauerte 7 Minuten und 29 Sekunden.
Das war die Aufteilung in einem instrumentierten Durchlauf meines lokalen Agenten-Workflows. Bei einem Durchlauf eines Log-Integritäts-Workflows auf meinem Operationsserver dauerte die entfernte Prüfung selbst 5,428 Sekunden und wurde erfolgreich abgeschlossen. Bevor diese Prüfung ausgeführt werden konnte, verbrachte derselbe Turn ungefähr 7 Minuten und 29 Sekunden mit der Verarbeitung von 66.170 Eingabetokens des erforderlichen Kontexts. Der schnelle Teil war das Tool. Der langsame Teil war alles, was der Workflow benötigte, bevor das Tool aufgerufen werden konnte.
Ein nützlicher Cloud-Agent umfasst mehr als die Modellantwort. Um diese herum gibt es einen Workflow: die Skills, die festlegen, wie eine Aufgabe erledigt werden soll, die MCP-Verbindungen, über die Tools und Dienste verfügbar gemacht werden, die Berechtigungen, die bestimmen, worauf zugegriffen werden darf, sowie den Browser oder die Shell, mit denen die Arbeit tatsächlich ausgeführt wird. Das lokal nachzubilden bedeutet, das System nachzubilden – nicht bloß ein Chatfenster mit einer Modell-API zu verbinden.
Der Workflow ist das Produkt, nicht der Endpunkt
Zwei Begriffe aus diesem Vokabular sollten klar definiert werden, denn die meisten Schwierigkeiten liegen hier und nicht beim Modell.
MCP, das Model Context Protocol, ermöglicht es einem Agent-Host, einem Modell Tools und Dienste bereitzustellen. Jeder MCP-Server veröffentlicht einen Katalog von Tools, die das Modell aufrufen kann. Hinter diesen Tools stehen die tatsächlichen Funktionen: Dateien, Repositories, Browser, Datenbanken und entfernte Dienste. Der Host vermittelt jeden Aufruf und setzt dabei auch die Berechtigungen durch.
Skills sind Workflow-Anweisungen. Ein Skill beschreibt, wie eine bestimmte Art von Aufgabe erledigt werden soll: welche Tools zu verwenden sind, was zu erfassen ist, in welcher Reihenfolge und was die Ausgabe enthalten soll. Er gibt dem Modell ein Vorgehen vor, doch das Modell kann weiterhin Schritte übersehen, weshalb eine Überprüfung nötig ist.
Entscheidend ist also das Zusammenspiel von Host, Modell, Laufzeit, Berechtigungen und Tool-Verbindungen. Der Host ist die Anwendung, mit der ich interagiere – in meinem Fall Kilo Desktop, Kilo in VS Code und AnythingLLM. Die Laufzeit stellt das Modell bereit. Das Modell übernimmt das Schlussfolgern. Die Skills und MCP-Verbindungen bestimmen, welche Aufgaben überhaupt möglich sind. Ein Inferenz-Endpunkt allein konfiguriert diese Skills, Verbindungen oder Berechtigungen nicht für den Agent-Host.
Was ich betreibe
Mein Serving-Stack besteht aus einem OpenAI-kompatiblen llama.cpp-Server (CUDA, Build b11852), auf dem Qwen 3 Coder Next (Q4_K_M) läuft. Den Modellmetadaten zufolge verfügt das Modell über insgesamt 79,67 Milliarden Parameter in 48 Schichten, und die quantisierten Gewichte belegen ungefähr 48 GB. Die Maschine hat eine RTX 4090 mit 24 GB VRAM, einen Ryzen 9 3900X mit 12 physischen Kernen und 24 Threads sowie 128 GB Systemspeicher. Die konfigurierte Kontextkapazität beträgt 131.072 Tokens, die maximale Antwortlänge 8.192 Tokens.
Qwen 3 Coder Next ist ein Mixture-of-Experts-Modell. Das bedeutet, dass es zahlreiche getrennte Expert-Gewichtssätze speichert und pro Token nur eine Teilmenge davon aktiviert. Die gespeicherten Gewichte sind daher umfangreich, obwohl die Berechnung pro Token nur einen Bruchteil davon beansprucht. Für diese Hardwareentscheidung ist die Größe der gespeicherten Gewichte ausschlaggebend: auch nach der Quantisierung etwa 48 GB.
Warum das Modell nicht auf die GPU passt
Etwa 48 GB quantisierte Gewichte bei 24 GB VRAM – das ist ein Rechenproblem, kein Problem, das sich durch Feinabstimmung lösen lässt. Die Q4_K_M-Quantisierung reduziert den Speicherbedarf der Gewichte auf Kosten von Präzision und Qualität. Sie sorgt jedoch nicht dafür, dass dieses Modell in 24 GB passt, insbesondere wenn auch Kontext und Laufzeitpuffer VRAM benötigen.
Die Lösung ist eine Aufteilung. Die Expert-Gewichte der ersten 32 der 48 Schichten werden der CPU beziehungsweise dem Systemspeicher zugewiesen; andere Tensoren verbleiben auf der GPU, mit einem begrenzten GPU-Expert-Cache. Genau genommen laufen dabei nicht 32 vollständige Schichten ausschließlich auf der CPU: In einem Mixture-of-Experts-Modell enthalten diese Schichten Expert-Gewichte, und die Expert-Gewichte dieser ersten 32 Schichten liegen im Systemspeicher.
Dazu kommen ein GPU-Expert-Cache von 1.024 MiB, ein Q8-KV-Cache und Flash Attention. Modellgewichte machen nur einen Teil des GPU-Speicherbedarfs aus. Die Laufzeit benötigt außerdem Arbeitsbuffer und den Attention-Zustand, der oft als KV-Cache bezeichnet wird. Q8 legt die Speicherpräzision unterstützter Cache-Tensoren fest. Der 1-GiB-Expert-Cache und Flash Attention sind weitere Kompromisse zwischen Speicherbedarf und Rechenaufwand; ihr jeweiliger Beitrag wurde in diesem Durchlauf nicht einzeln ermittelt.
Warum die einzelnen Komponenten gewählt wurden
Das sind praktische Entscheidungen für eine bestimmte Maschine und Arbeitslast, keine durch Benchmarks belegten Optimalwerte.
| Auswahl | Begründung | Einschränkung |
|---|---|---|
| llama.cpp-Laufzeit | Bietet explizite Steuerungsmöglichkeiten für Quantisierung und Schichtplatzierung und stellt eine OpenAI-kompatible API bereit, die der Agent-Host nutzen kann | Eine Laufzeit, kein Modell; ein Wechsel macht dasselbe Modell nicht intelligenter |
| Coding-orientiertes MoE-Modell | Ein Versuch, eine reale Aufgabe und Tool-Arbeitslast statt einer Chat-Demo zu unterstützen | Eine Gleichwertigkeit mit führenden Cloud-Modellen ist nicht belegt; frühere lokale Durchläufe erforderten weiterhin menschliche Korrekturen |
| Q4_K_M-Quantisierung | Reduziert den Speicherbedarf der Gewichte ausreichend, um eine hybride Platzierung zu ermöglichen | Ein Kompromiss zwischen Präzision und Qualität, kein kostenloser Vorteil |
| Aufteilung zwischen CPU und GPU | Der VRAM ist begrenzt und reicht für die Gewichte nicht aus | Die Expert-Gewichte der ersten 32 von 48 Schichten liegen im Systemspeicher; der Rest läuft auf der GPU |
| Kontextobergrenze von 128K | Spielraum für Anweisungen, Skill- und Tool-Definitionen, Aufgabeneingaben, Tool-Ergebnisse und Ausgabe | Eine konfigurierte Kapazität, kein Bedarf pro Turn |
| Eine gleichzeitige Anfrage, 12 CPU-Threads | Begrenzt den Speicherbedarf entsprechend dem verfügbaren RAM und den physischen Kernen | Für andere Arbeitslasten nicht als optimal erwiesen |
| Native Windows-Bereitstellung | Umging die 32-GB-RAM-Grenze der WSL-VM und die Schwierigkeiten beim Laden des Modells über in Windows eingebundene Dateien | Kilos eigene Linux-Betriebsbefehle laufen weiterhin in WSL |
Was bei einem Durchlauf tatsächlich geschah
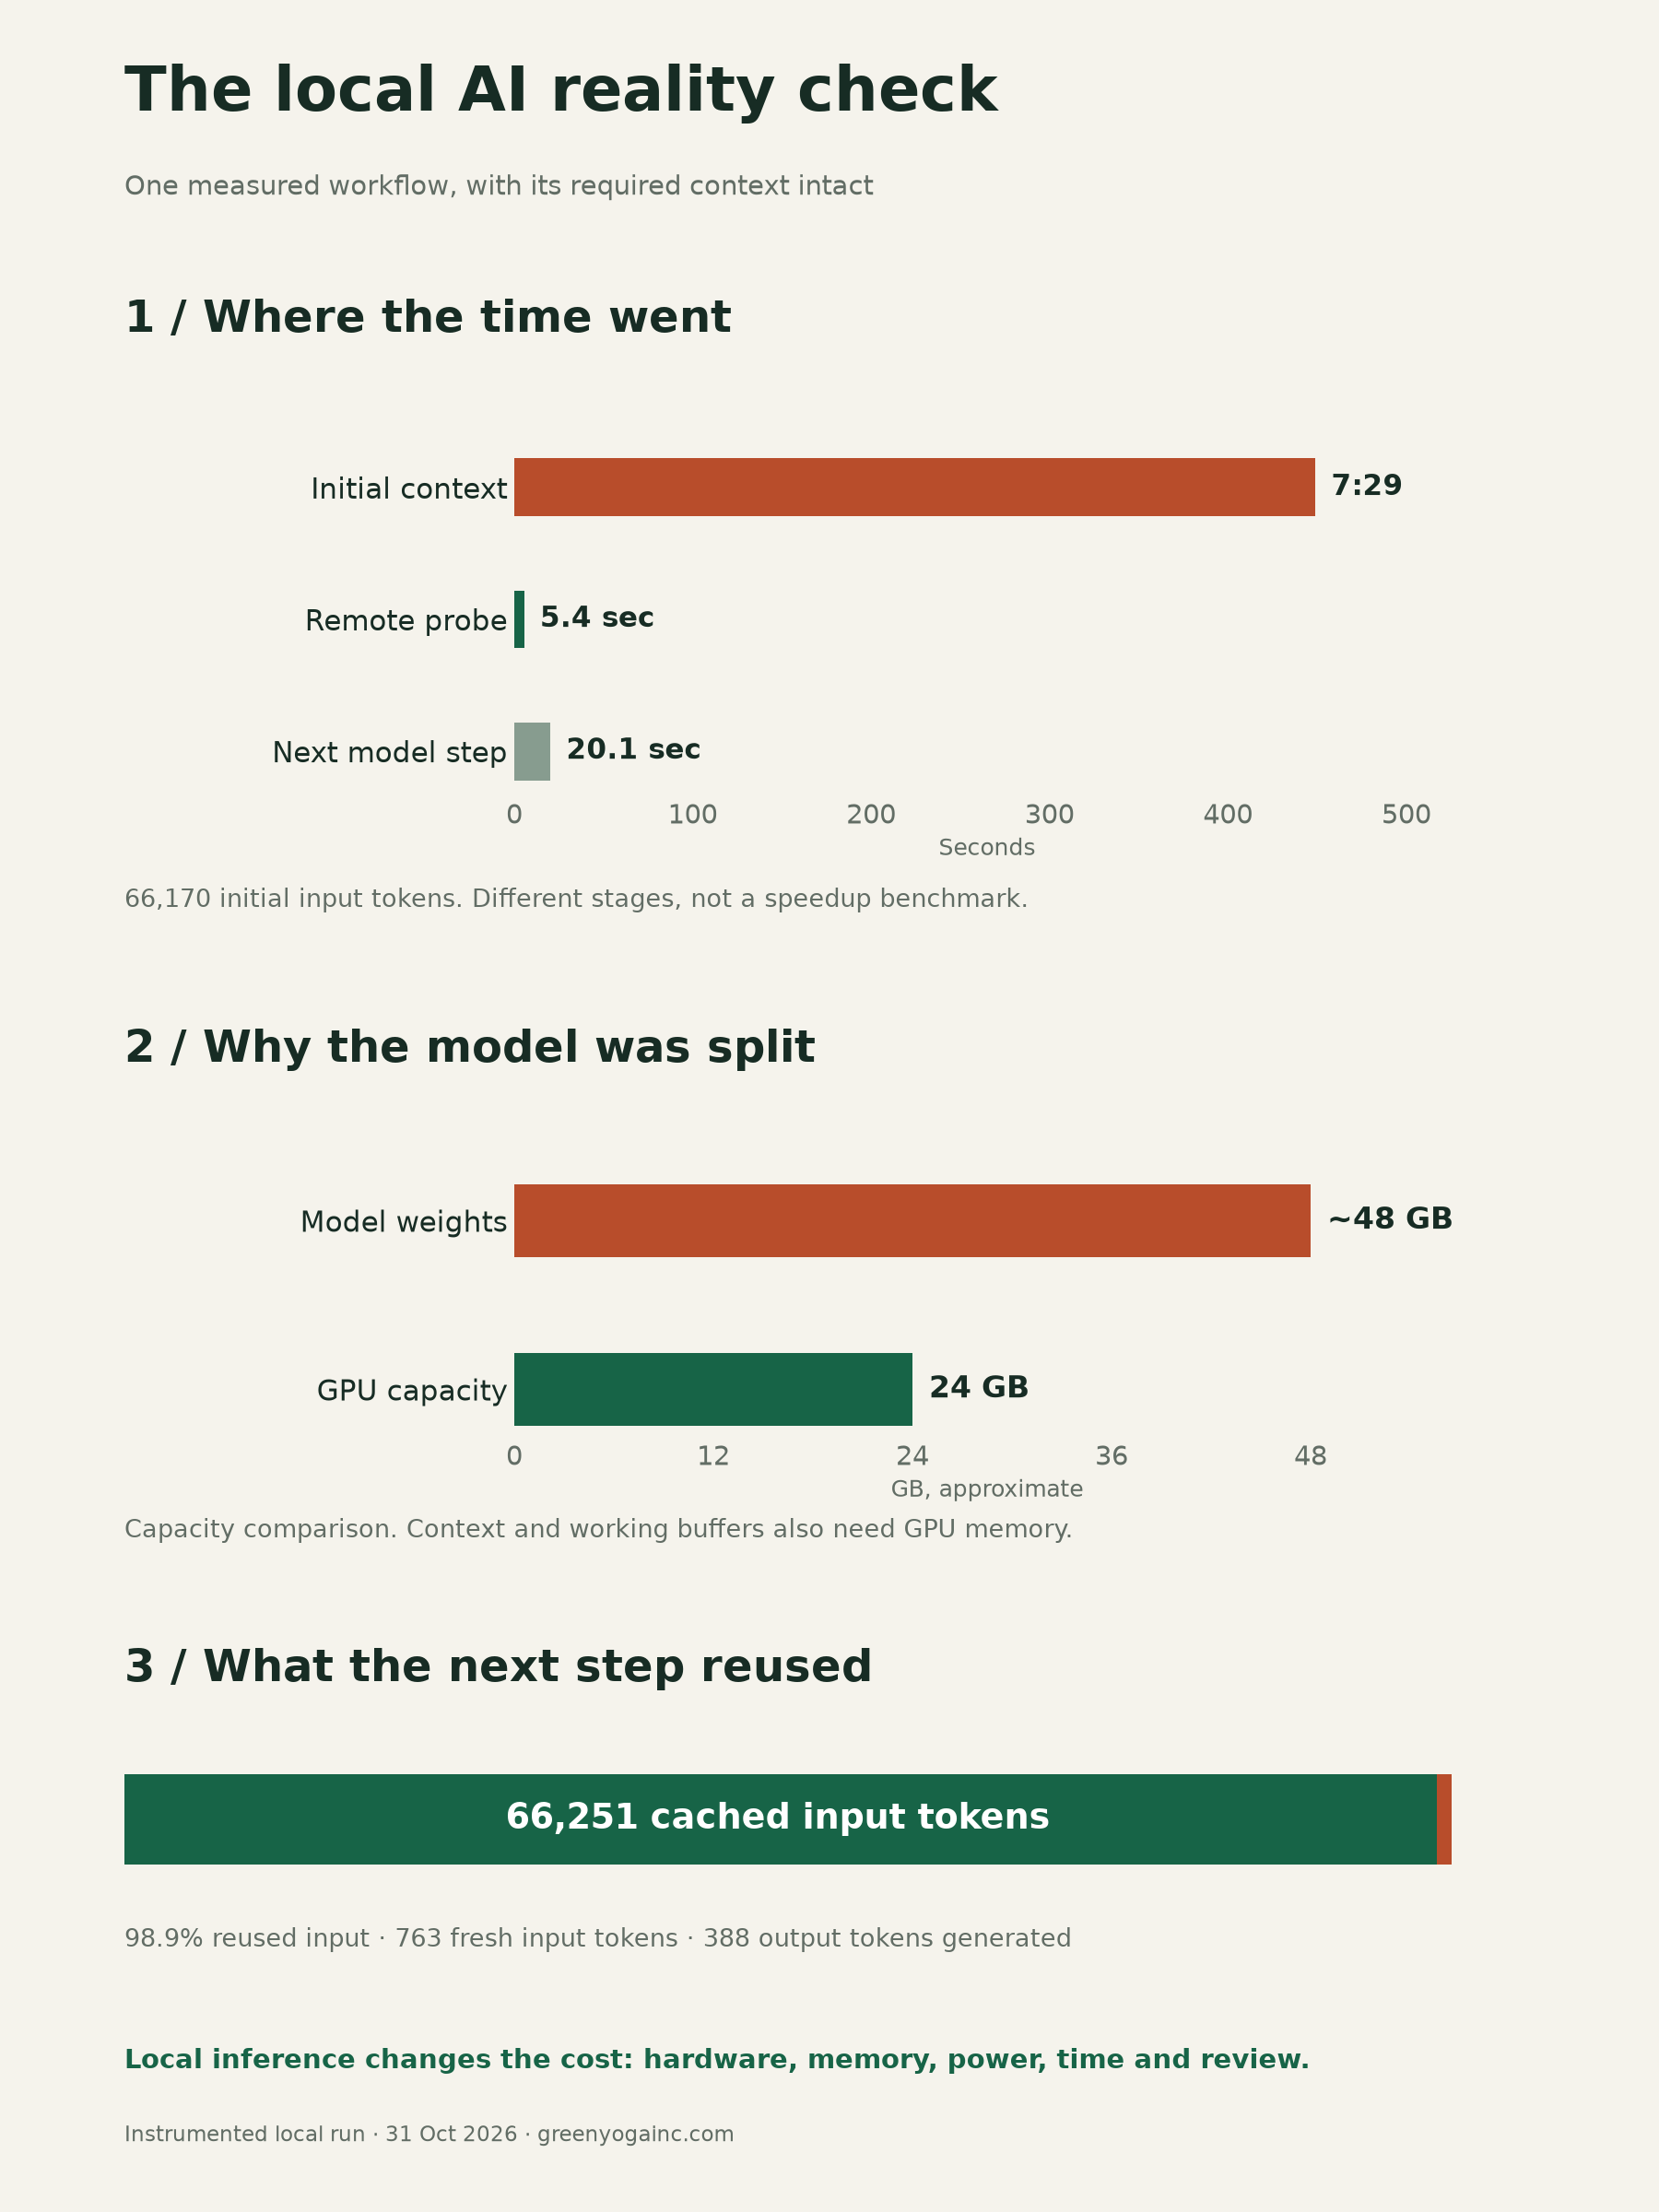
| Phase | Dauer | Details |
|---|---|---|
| Verarbeitung von Eingabe und Kontext | 448,92 s (7 min 29 s) | 66.170 anfängliche Eingabetokens, effektiv etwa 147 Eingabetokens/s |
| Entfernte Log-Integritätsprüfung | 5,428 s | Exit-Code 0, auf meinem Operationsserver |
| Nachfolgende Modellantwort | 20,1 s | 66.251 wiederverwendete Eingabetokens, 763 neue, 388 Ausgabetokens, etwa 98,9 % wiederverwendet |
Das sind drei verschiedene Phasen eines Durchlaufs, keine direkt vergleichbaren Messungen. Die 448,92 Sekunden sind die einmalig beobachtete Kaltverarbeitung eines umfangreichen Kontexts in einem Workflow. Die 5,428 Sekunden entfallen auf die Arbeit der entfernten Prüfung. Die 20,1 Sekunden entfallen auf einen zweiten Modellschritt, nachdem das Tool zurückgekehrt war. Es wäre falsch, 449 Sekunden und 20,1 Sekunden als Beschleunigung derselben Aufgabe zu betrachten: Es wurde unterschiedliche Arbeit geleistet, und der zweite Schritt übernahm ein bereits aufgewärmtes Präfix.
Woher die Wiederverwendung kam
Dieser Folgeschritt verwendete 66.251 Eingabetokens wieder und verarbeitete 763 neue – eine Wiederverwendungsquote von ungefähr 98,9 %. Zwei unterschiedliche Mechanismen werden dabei leicht verwechselt, daher lohnt es sich, sie zu unterscheiden. Beim KV-Caching wird der Attention-Zustand gespeichert, damit vorherige Tokens nicht bei jedem Generierungsschritt auf dieselbe Weise neu berechnet werden müssen; Q8 bezeichnet eine Wahl der Speicherpräzision. Die Präfix-Wiederverwendung ist ein Verhalten: Die Engine erkannte, dass der Anfang der Anfrage mit bereits verarbeitetem Inhalt übereinstimmte, und übersprang die erneute Verarbeitung dieses Teils. Keiner der beiden Mechanismen verkleinert die Modellgewichte, und keiner bedeutet einen Rabatt auf Cloud-Abrechnungen. Die Abrechnung von Eingabecaches bei Cloud-Anbietern ist ein separater Mechanismus mit eigenen Regeln und Tarifen.
Verfügbarkeit ist ein separates Problem
Am 31. Oktober 2026 blieb meine Kilo-Desktop-Sitzung bei einem Ladesymbol hängen, also bat ich darum, die festgefahrene Sitzung zu untersuchen. Die Ursache war weder die Modellqualität noch die Kontextgröße oder ein Tool-Fehler. Der lokale Modellserver war ausgeschaltet. Kilo versuchte es wiederholt und erhielt ECONNREFUSED, doch anhand des Ladesymbols war die Ursache nicht erkennbar.
Das Starten des Servers stellte die bestehende Sitzung wieder her. Es musste kein Kontext verworfen und keine Arbeit wiederholt werden. Die dauerhafte Lösung war ein bedarfsgesteuerter Starter: den Server starten, warten, bis er bereit ist, und dann Kilo öffnen. Ich fügte nichts zur Windows-Anmeldung hinzu, weil ich das auf einem Rechner vorzog, den ich auch interaktiv nutze. Die llama.cpp- und Qwen-Einrichtung selbst war bereits vorhanden; der Vorfall änderte, wie der Server gestartet wird, nicht, wie das Modell bereitgestellt wird.
Erwähnenswert ist das, weil es die gegenteilige Lehre zu den obigen Zeitmessungen darstellt: Ein schnelles Modell auf einem nicht verfügbaren Server liefert überhaupt nichts.
Die Kosten des Prompts – ehrlich betrachtet
Der Prompt in diesem Durchlauf war umfangreich, weil der Workflow das erforderte. Anweisungen, Skill-Definitionen, Tool-Definitionen, die Aufgabe und Platz für Tool-Ergebnisse summieren sich. Ich habe kein Interesse daran, Skills oder MCP-Verbindungen zu entfernen, nur damit eine Zahl besser aussieht. Ein Benchmark mit einem ausgehöhlten Workflow beschreibt keinen funktionierenden Agenten.
Vergleichen wir daher die Kostenkategorien ehrlich, statt sie in einen einzigen Wert zu pressen.
Cloud-Tarife können Eingabetokens, Ausgabetokens und gecachte Eingaben unterschiedlich abrechnen. Der Kostenanteil für nicht gecachte Eingaben entspricht ungefähr der Zahl der Eingabetokens geteilt durch eine Million, multipliziert mit dem Eingabepreis des Anbieters pro Million Tokens. Die Abrechnung der Ausgabe und etwaige Cache-Rabatte hängen vom Anbieter und Tarif ab. Die tatsächliche Abrechnung hängt also davon ab, welcher Anbieter und welcher Preistarif gelten; ich werde dafür keinen Dollarbetrag erfinden.
Lokale Inferenz beseitigt die API-Gebühr pro Token für dieses lokale Modell. Gebühren für kostenpflichtige Tools oder entfernte Dienste fallen dadurch jedoch nicht weg, und die lokale Inferenz ist nicht kostenlos. Zu den Kosten gehören die Hardware, die Speicher- und VRAM-Kapazität, der Stromverbrauch, die Wartung der Einrichtung, die Wartezeit in Echtzeit und die menschliche Prüfung der Ausgabe. Diese Kosten sind real und werden nicht geringer, nur weil die Inferenz lokal erfolgt.
Ein oft übersehener Punkt: Lokale Inferenz macht entfernte MCP-Aufrufe weder lokal noch offline. Meine Tools greifen weiterhin über das Netzwerk auf entfernte Dienste zu. Was meinen Rechner verlässt, ist der Tool-Datenverkehr; das Modell, das entscheidet, welche Aufrufe erfolgen, ist nur ein Teil dessen, was offengelegt wird.
Unterscheiden Sie auch die Kontextkapazität von 128K von den 66.170 verarbeiteten Tokens. Erstere ist eine Einstellung, Letztere ist die tatsächlich in diesem Turn gesendete Menge. Keine der beiden Angaben entspricht den abrechenbaren Tokens oder den Kosten für den Abschluss der Aufgabe.
Was dieser Durchlauf zeigt – und was nicht
Das beobachtete Ergebnis war bescheiden und real: Die Live-Skill-Prüfung wurde auf meinem Operationsserver abgeschlossen, Kilo erstellte einen Bericht, und dieser enthielt Belege, die ein Mensch überprüfen konnte. Die Prüfung und die Antwort wurden abgeschlossen. Das allein beweist nicht, dass jede Skill-Anweisung befolgt oder jede Schlussfolgerung richtig war.
Das ist das Kriterium, auf das es mir tatsächlich ankommt: Abschluss und Richtigkeit, nicht Geschwindigkeit. Siebeneinhalb Minuten zu warten ist ein akzeptables Ergebnis, wenn der Agent seinem Skill folgt, die richtigen Tools aufruft und etwas zur Überprüfung zurückliefert. Eine unvollständige Antwort hat für diesen Workflow keinen Wert.
Daraus folgt nicht, dass diese Einrichtung allgemein zuverlässig ist, einem führenden Cloud-Modell entspricht oder dass die hier gemessenen Zeiten Ihre eigenen vorhersagen. Ein Durchlauf ist ein Durchlauf. Und ein Diagramm zur Prompt-Verarbeitungszeit misst den Aufwand für die Eingabe des Modells, nicht die Qualität seiner Ausgabe. Ob sich der Workflow lohnt, hängt von seiner Vollständigkeit, der Ausgabequalität und dem Prüfaufwand ab.
Wenn Sie Agenten-Workflows lokal ausführen: Wie viel Zeit nehmen Sie für die Prompt-Verarbeitung in Kauf, und wie entscheiden Sie, ob sich das Warten auf einen langsamen Turn lohnt?
Belegvermerk: Diese Zahlen stammen aus dem einzelnen instrumentierten lokalen Durchlauf eines Nutzers am 31. Oktober 2026; die Zeitangaben sind Näherungswerte aus einem realen Workflow. Es handelt sich weder um einen standardisierten Benchmark noch um einen kontrollierten Vergleich von Ollama und llama.cpp oder um einen Leistungs- beziehungsweise Kostenvergleich zwischen Cloud und lokalem Betrieb.