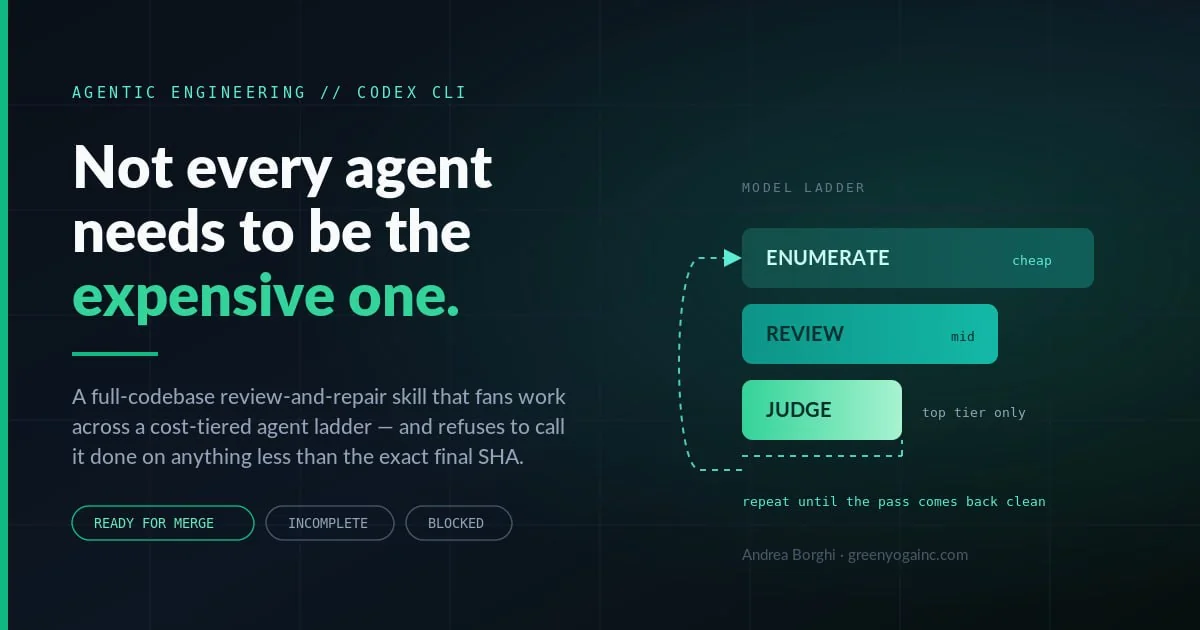
一个全代码库审查与修复技能,将工作分摊到一个按成本分层的智能体阶梯上——并且在未达到精确的最终 SHA 之前,拒绝宣称完成。
我最近一段时间一直在构建一个 Codex 技能,用于审查整个仓库并修复所发现的问题。审查本身相对简单,真正的难点在于阻止它在尚未完成时却声称已经完成。
最终方案的形成取决于三件事。
枚举不等于判断。两件事不必以同一档计价。
列出被跟踪的文件、构建覆盖率清单(manifest)、运行命令并返回结果——这些是事务性的工作。在一次全仓库审计中,这部分消耗了大部分 token,却几乎不涉及真正的思考;如果把它路由到顶级模型,正是我知道的最快烧钱方式——只为生成一份文件清单。
因此,这个技能将工作拆分为一个阶梯:
- ENUMERATE(枚举)—
cheap。列出所有存在的项。文件、模块、测试覆盖率、与主干分支的差异、我们将触及的清单。不带任何观点,不作任何判断。 - REVIEW(审查)—
mid。遍历清单,对发现进行分组。针对每一组发现,撰写最小化的补丁(minimal patch),并写一段简短的说明,明确指出它要避免的失效模式。 - JUDGE(裁决)— 仅限
top tier。重新审阅每一个拟议补丁,并对照其所涉及的代码进行核查。批准、驳回,或打回要求重新进行枚举。在这一步出错代价高昂,因此昂贵的模型也正是从这里体现出价值所在:授权路径、并发与取消、事务与迁移安全、跨文件的契约。
图中那条虚线回路并非装饰。裁决者的驳回不会终止整个流程——它会将工作以更窄的范围打回给枚举器。repeat until the pass comes back clean(重复,直到返回的检查结果为干净)才是真正的契约。
Codex 子智能体共享同一文件系统。
这是让我意外的地方。不会有隔离的副本,也没有合并步骤。任何智能体的写入对其他所有智能体——包括即将被创建的下一个智能体——立即可见。
这彻底改变了工作流的设计思路。让三个审查者各自克隆仓库并产出各自的差异(diff)毫无意义;最后写入的人会赢,其他人的工作会凭空消失。因此,该技能将工作树视为一块共享的黑板:枚举器写入清单,审查器读取清单并针对每组发现追加一个补丁文件,裁决器读取这些补丁,应用它批准的补丁,然后重新运行构建。验证步骤才是闭合这个回路的关键。
另一个推论是:技能自身不能信任自己的进度标记。“我已应用了 14 个补丁”在下一个智能体将其覆盖的情况下毫无意义。因此,技能并不依赖计数器或“已完成”标记,而是以唯一真正能存续下来的东西作为完成判定依据:工作树的精确最终 SHA。当裁决者签字放行后,本次运行记录该 SHA,下一次调用在恢复前会先比对当前工作树与该 SHA 是否一致。若 SHA 与上一次干净通过的记录不符,流程会从枚举阶段重新开始——不是因为工作做错了,而是因为底层的状态已经发生了变化。
状态标签不是感受,而是 SHA。
- READY FOR MERGE(可合并)—— 记录的 SHA 与当前工作树的 SHA 完全一致,构建通过,且裁决者批准了所有补丁。
- INCOMPLETE(未完成)—— 已经应用了改动,但自上一次干净通过以来工作树已发生偏移,或裁决者驳回了若干组发现并将其打回要求重新枚举。
- BLOCKED(已阻塞)—— 循环跑完但仍然失败:要么是裁决者持续驳回的某个组,要么是构建始终无法变绿。需要人工介入查看。
这套阶梯的核心目的,就是把廉价档保持廉价,把昂贵档留给真正能体现价值的地方,并让最终结论来自文件系统所无法伪造的那一项依据。