一次工具调用耗时 5.4 秒。处理所需的上下文却用了 7 分钟 29 秒。
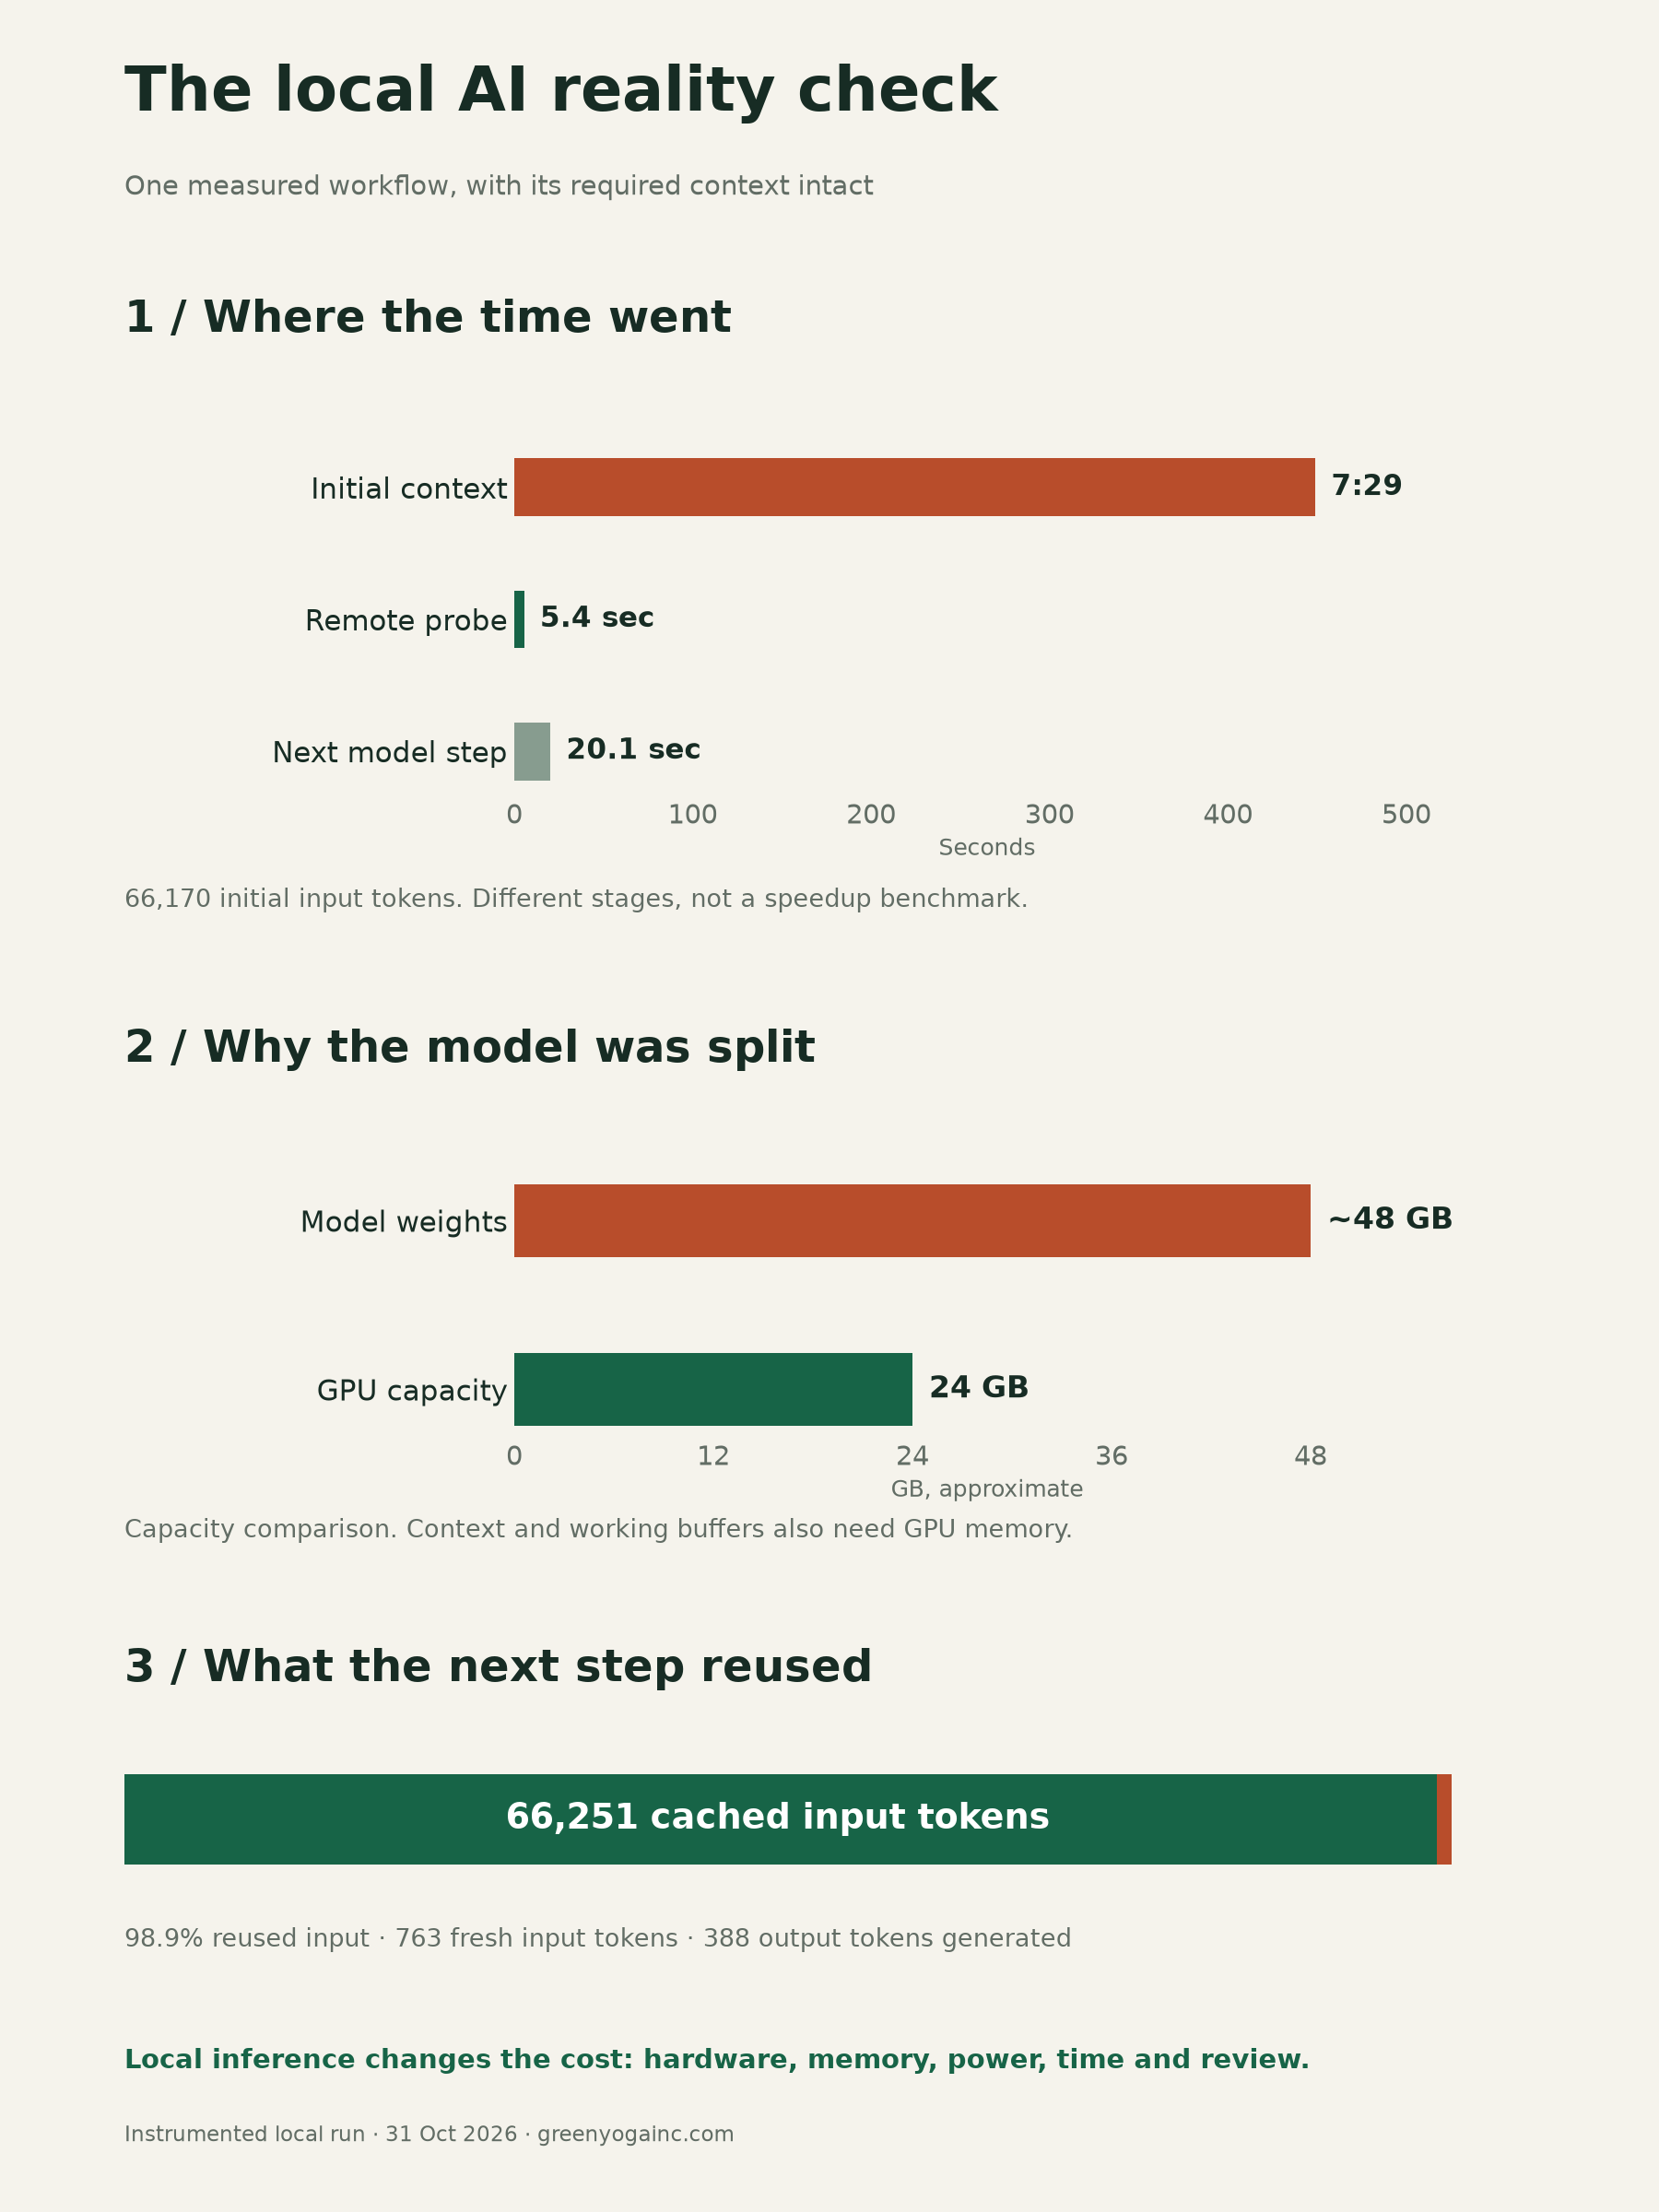
这是我本地智能体工作流在一次有指标记录的运行中所呈现的差异。在针对我的运营服务器运行日志健康检查工作流时,仅远程探测本身就耗时 5.428 秒,并正常退出。在执行探测之前,同一轮对话用了大约 7 分钟 29 秒处理所需的 66,170 个输入词元。快的是工具。慢的是工具被调用之前工作流所需的一切准备。
一个实用的云端智能体所包含的不只是模型响应。其周围还有一整套工作流:规定任务执行方式的技能、公开工具和服务的 MCP 连接、决定哪些内容可以访问的权限,以及真正执行工作的浏览器或命令行环境。在本地复现它意味着复现整个系统,而不是简单地把一个聊天窗口指向模型 API。
工作流才是产品,而非端点
这套术语中有两个概念值得明确定义,因为大多数困难都出在这里,而不是出在模型上。
MCP,即模型上下文协议,是智能体宿主向模型公开工具和服务的机制。每个 MCP 服务器都会发布一份模型可以调用的工具目录,而这些工具背后才是真正的能力:文件、代码仓库、浏览器、数据库和远程服务。宿主会协调每一次调用,权限也正是在这里执行。
技能是工作流指令。一项技能会说明如何完成特定类型的任务:使用哪些工具、收集哪些信息、按照什么顺序处理,以及输出应包含哪些内容。它为模型提供了一套可遵循的流程,不过模型仍可能遗漏步骤,因此需要验证。
所以,真正重要的是宿主、模型、运行时、权限和工具连接共同构成的系统。宿主是你与之交互的应用程序,就我而言,是 Kilo Desktop、VS Code 中的 Kilo 和 AnythingLLM。运行时为模型提供服务,模型负责推理,而技能和 MCP 连接决定哪些工作甚至有可能完成。仅凭一个推理端点,无法为智能体宿主配置这些技能、连接或权限。
我的运行环境
我的服务栈是一个兼容 OpenAI API 的 llama.cpp 服务器(CUDA,版本 b11852),运行 Qwen 3 Coder Next(Q4_K_M)。模型元数据显示,其总参数量为 79.67 billion,分为 48 层,量化后的权重约占 48 GB。机器配备一块拥有 24 GB 显存的 RTX 4090、一颗拥有 12 个物理核心和 24 个线程的 Ryzen 9 3900X,以及 128 GB 系统内存。配置的上下文容量为 131,072 个词元,最大响应长度为 8,192 个词元。
Qwen 3 Coder Next 是一种混合专家模型。这意味着它会存储许多彼此独立的专家权重集,并且每个词元只激活其中一个子集。因此,即使每个词元所涉及的计算只触及其中一小部分权重,存储的权重仍然很大。对于这项硬件决策而言,权重存储大小很重要:即使经过量化仍约为 48 GB。
为什么模型无法装入 GPU
约 48 GB 的量化权重对 24 GB 显存而言,是一个算术问题,而不是调优问题。Q4_K_M 量化可以在精度与质量之间权衡的情况下减少权重存储,但无法让这个模型适配 24 GB,尤其是在上下文和运行时缓冲区也需要占用显存的情况下。
解决方案是采用拆分部署。48 层中前 32 层的专家权重被分配到 CPU/系统内存一侧;其他张量仍保留在 GPU 上,并设置有容量上限的 GPU 专家缓存。准确地说,这并不是只有前 32 个完整层在 CPU 上运行:在混合专家模型中,这些层容纳的是专家权重,实际存放在系统内存中的是前 32 层的专家权重。
除此之外还有:1,024 MiB 专家 GPU 缓存、Q8 KV 缓存和 Flash Attention。模型权重只是 GPU 内存使用的一部分。运行时还需要工作缓冲区和注意力状态,后者通常称为 KV 缓存。Q8 用于控制受支持缓存张量的存储精度。1 GiB 专家缓存和 Flash Attention 是进一步的内存/计算权衡;在本次运行中,并未单独隔离它们各自的贡献。
为什么采用这些组成部分
这些是针对一台机器和一种工作负载的实用选择,而不是经基准测试证明的最优方案。
| 选择 | 理由 | 限定条件 |
|---|---|---|
| llama.cpp 运行时 | 提供明确的量化和层部署控制,并提供智能体宿主可使用的兼容 OpenAI API | 这是运行时,不是模型;更换它不会让同一个模型变得更聪明 |
| 面向编程的 MoE 模型 | 旨在支持真实的任务和工具工作负载,而不是聊天演示 | 尚未证明能与前沿云端模型相当;早期本地运行仍需人工修正 |
| Q4_K_M 量化 | 将权重存储减少到足以支持混合部署的程度 | 这是在精度与质量之间权衡,而非毫无代价的提升 |
| CPU 与 GPU 拆分 | 显存容量有限,而权重超出其容量 | 48 层中前 32 层的专家权重位于系统内存中;其余部分在 GPU 上运行 |
| 128K 上下文上限 | 为指令、技能和工具定义、任务输入、工具结果及输出留出余量 | 这是配置的容量,而非每轮对话的要求 |
| 单并发请求、12 个 CPU 线程 | 将内存需求控制在可用 RAM 和物理核心数量之内 | 尚未证明适合其他工作负载时达到最优 |
| 原生 Windows 服务 | 避开 WSL 虚拟机的 32 GB RAM 上限,以及通过 Windows 挂载文件加载模型时的障碍 | Kilo 自身的 Linux 操作命令仍需在 WSL 中运行 |
一次运行实际完成了什么
| 阶段 | 耗时 | 详情 |
|---|---|---|
| 处理输入和上下文 | 448.92 s (7 min 29 s) | 初始输入为 66,170 个词元,有效速度约为 147 个输入词元/秒 |
| 远程日志健康探测 | 5.428 s | 针对我的运营服务器运行,退出代码为 0 |
| 后续模型响应 | 20.1 s | 复用 66,251 个输入词元,新增 763 个,输出 388 个词元,复用率约为 98.9% |
这是同一次运行中的三个不同阶段,并非同类条件下的比较。448.92 秒是在一个工作流中一次性观察到的冷启动大上下文处理时间。5.428 秒是远程探测执行任务所用的时间。20.1 秒则是工具返回后模型的第二个步骤。将 449 秒与 20.1 秒解读为同一任务的速度提升是错误的,因为两者执行的工作不同,而且第二个步骤继承了一个已处于热状态的前缀。
复用从何而来
后续步骤复用了 66,251 个输入词元,并处理了 763 个新词元,复用率约为 98.9%。这里很容易混淆两种不同机制,因此有必要将其区分开来。KV 缓存会存储注意力状态,使之前的词元不必在每个生成步骤中以相同方式重新计算;Q8 是一种存储精度选择。前缀复用则是一种行为:引擎发现请求的开头与已处理过的内容相匹配,于是跳过了对这部分内容的重新处理。两者都不会缩小模型权重,也都不是云端计费折扣。云服务商的输入缓存核算属于另一种机制,有其自己的规则和费率。
可用性是另一个问题
2026 年 10 月 31 日,我的 Kilo Desktop 会话一直停留在加载动画中,因此我请求调查这个卡住的会话。原因并不是模型质量、上下文大小或工具错误。本地模型服务器处于关闭状态。Kilo 持续重试并收到 ECONNREFUSED,而加载动画始终无法让这一原因变得清晰可辨。
启动服务器后,原有会话得以恢复。不需要丢弃任何上下文,也不需要重做任何工作。持久的解决方案是使用按需启动器:启动服务器、等待其就绪,然后打开 Kilo。没有向 Windows 登录启动项添加任何内容,这是我更偏好的方式,因为这台机器也用于交互操作。llama.cpp 和 Qwen 的配置本身在此之前就已就绪;这次事件改变的是服务器的启动方式,而不是模型的提供方式。
这一点值得指出,因为它与上面的耗时结论正好相反。服务器不可用时,再快的模型也什么都无法产生。
坦诚看待提示词成本
本次运行的提示词很大,是因为工作流本身需要这些内容。指令、技能定义、工具定义、任务以及容纳工具结果的空间加在一起构成了规模,而我不打算为了让数字看起来更好而删减技能或 MCP 连接。一个建立在被掏空的工作流之上的基准测试,无法描述一个真正可用的智能体。
因此,应坦诚比较不同的成本类别,而不是将它们混为一谈。
云端套餐可能会对输入词元、输出词元和缓存输入采用不同的计费方式。未缓存输入的费用大致等于输入词元数除以一百万,再乘以服务商每百万输入词元的价格。输出计费及任何缓存折扣取决于服务商和套餐。因此,实际费用取决于具体的服务商和定价层级,我不会凭空编造一个美元数字。
对于该本地模型,本地推理免除了按词元收取的 API 费用。它并未免除付费工具或远程服务的费用,因此并不是免费的。成本包括硬件、内存和显存容量、耗电量、配置维护、你等待运行所花费的实际时间,以及对输出进行人工审核。这些成本都是真实存在的,并不会因为推理在本地进行而减少。
还有一点常被忽视:本地推理并不会让远程 MCP 调用变成本地调用或离线调用。我的工具仍会通过网络访问远程服务。离开本机的数据传输是工具流量,而模型决定调用什么只是其中一部分暴露风险。
另外,应将 128K 上下文容量与实际处理的 66,170 个词元区分开来。前者是设置,后者是本轮对话实际发送的数量。两者都不等同于计费词元,也都不等同于完成任务的成本。
这次运行说明了什么,又没有说明什么
观察到的结果既有限但也很真实:实时技能探测成功连接我的运营服务器并完成,Kilo 生成了一份报告,报告返回了可供人工审核的证据。探测和响应均已完成。但仅凭这一点,并不能证明每项技能指令都得到了遵循,也不能证明每项结论都正确无误。
这才是我真正关心的标准。完成度和正确性,而不是速度。当智能体遵循其技能、调用正确的工具并返回可供审核的内容时,等待七分半钟是可以接受的结果。未完成的答案对这个工作流毫无价值。
但这并不意味着这套配置总体可靠,也不意味着它能与前沿云端模型相媲美,更不意味着这里的耗时能够预测你自己的体验。一次运行就是一次运行。而提示词处理时间图表所衡量的是向模型输入内容的成本,而不是模型产出的质量。完成度、输出质量和审核成本决定了这个工作流是否值得运行。
如果你在本地运行智能体任务,你的提示词处理预算是多少?你如何判断一轮缓慢的对话是否值得等待?
证据说明: 这些数据来自一位用户在 2026 年 10 月 31 日的一次有指标记录的本地运行,基于一个真实工作流得出近似耗时。它们不是标准化基准测试,不是受控的 Ollama 与 llama.cpp 对比,也不是云端与本地的性能或成本对比。