एक टूल कॉल में 5.4 सेकंड लगे। उसके लिए आवश्यक संदर्भ को प्रोसेस करने में 7 मिनट 29 सेकंड लगे।
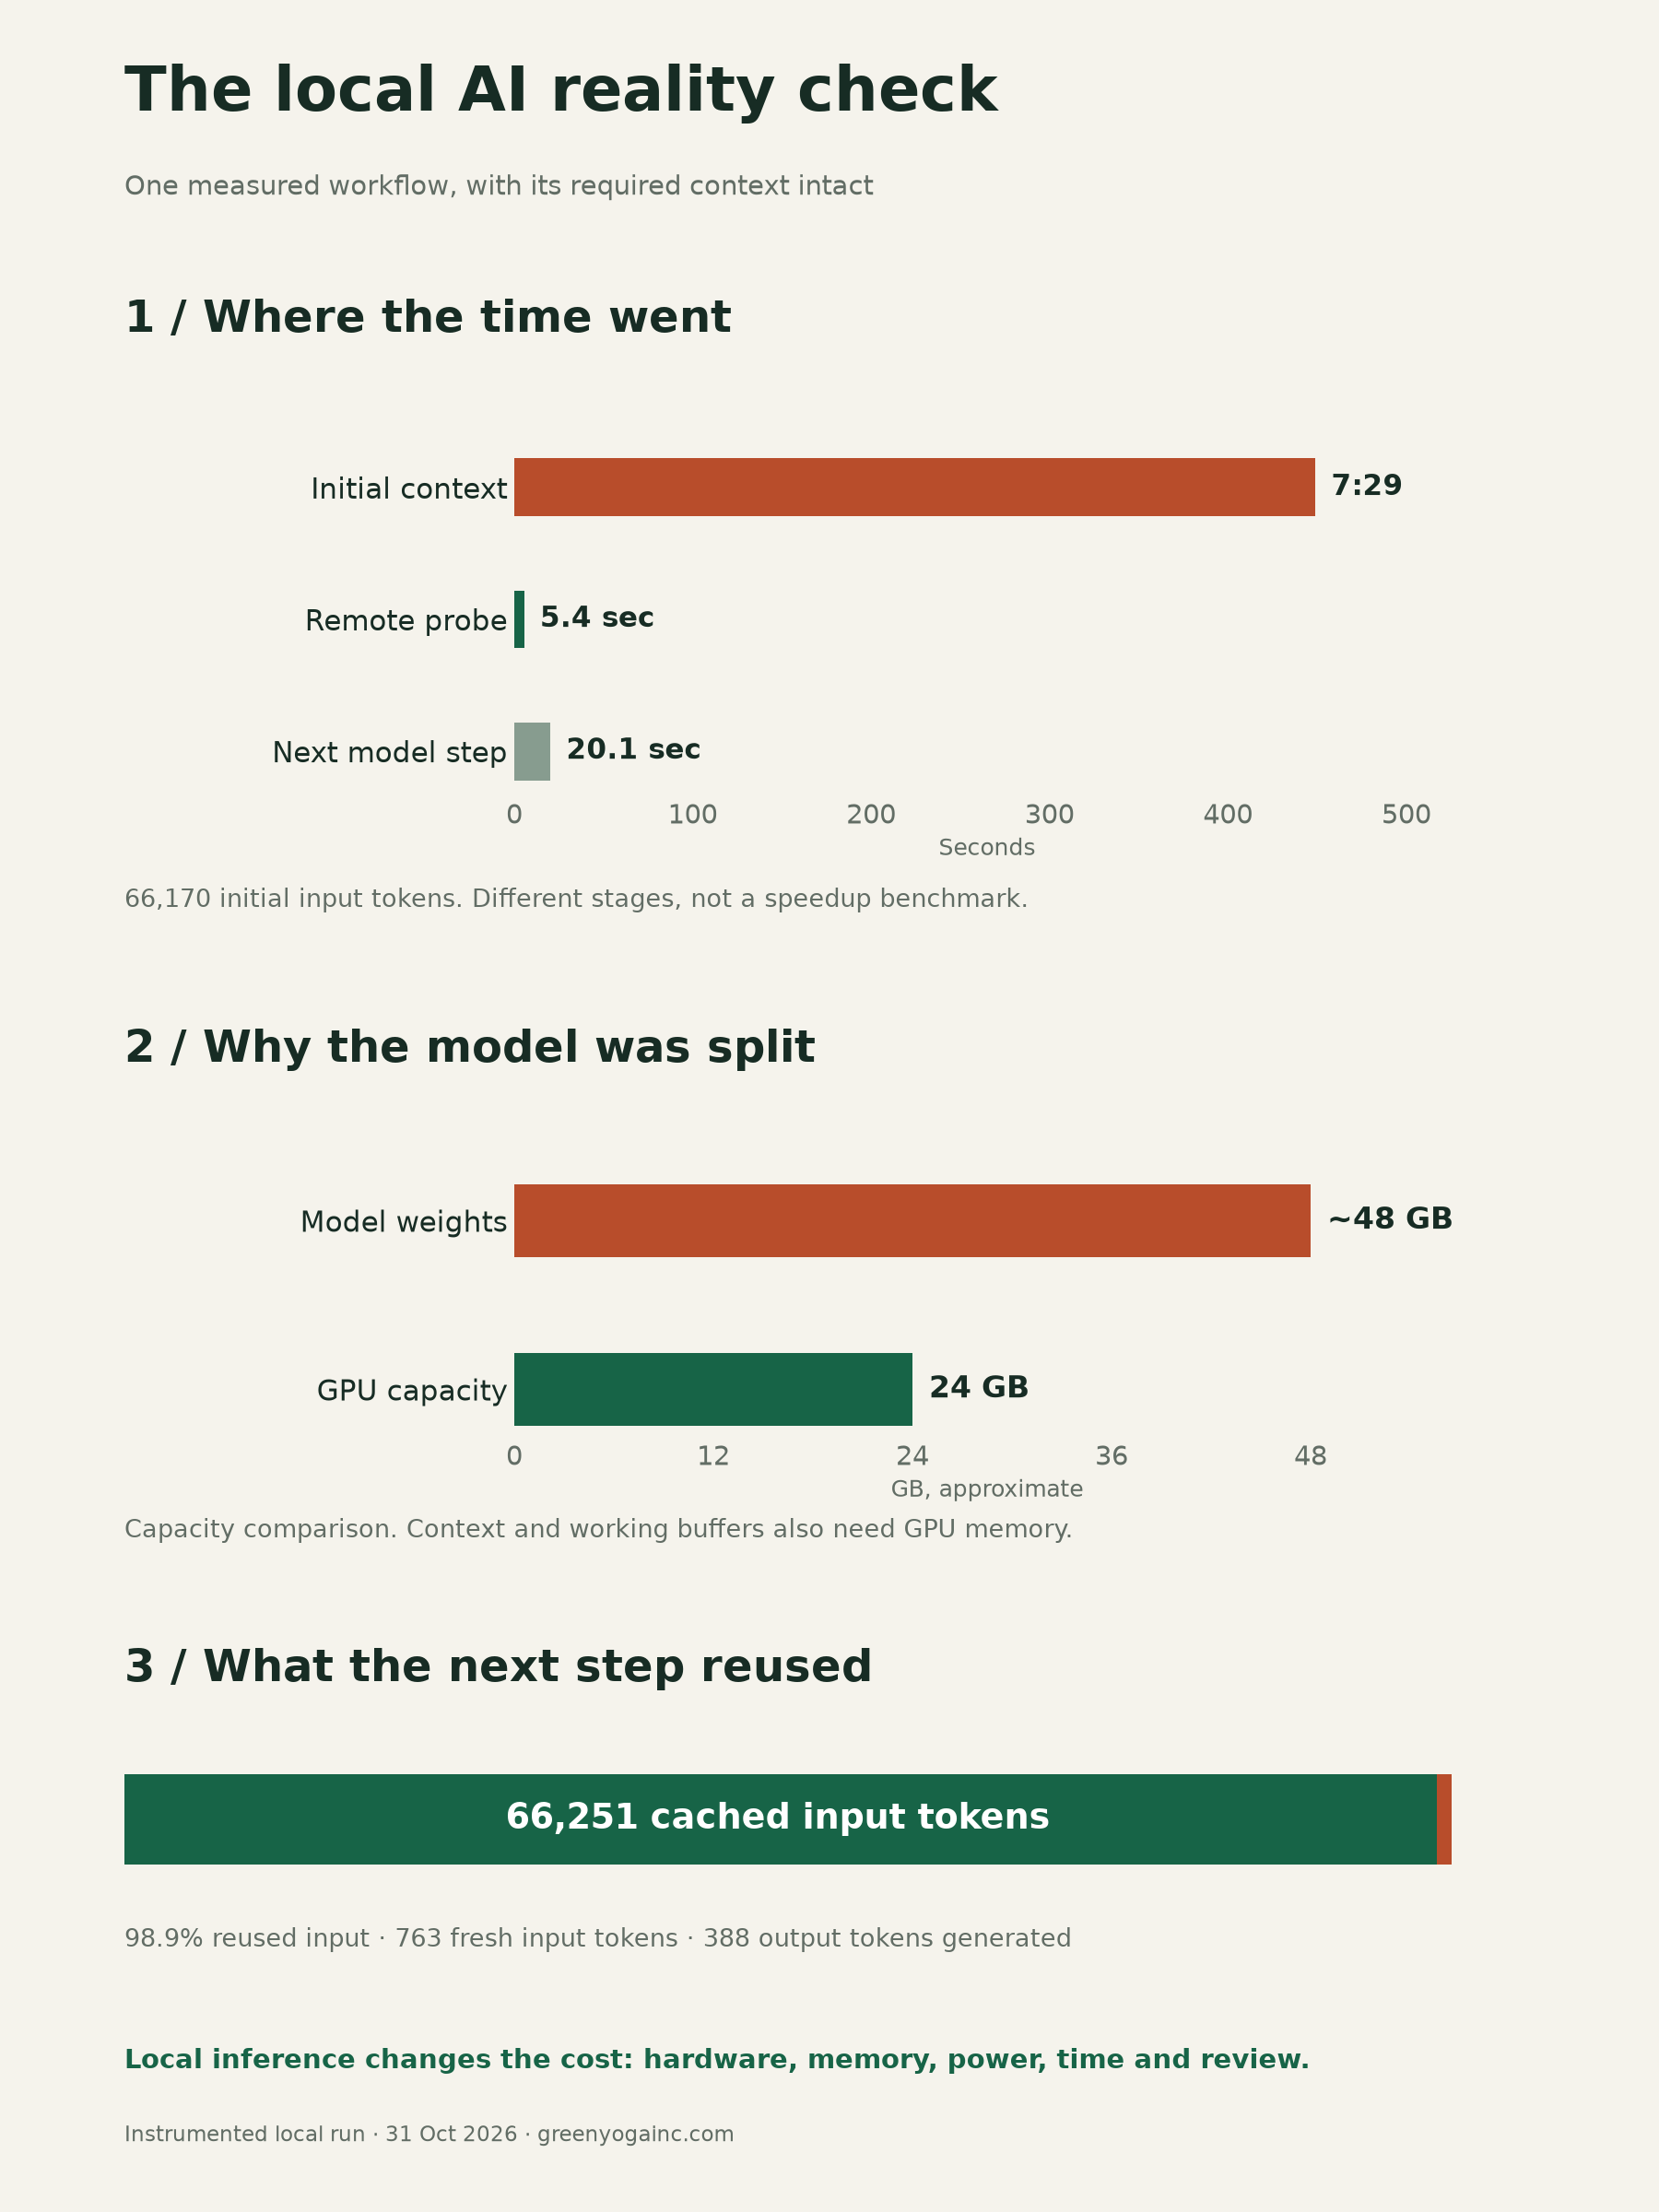
मेरे लोकल एजेंट वर्कफ़्लो के एक यंत्रीकृत रन में यही विभाजन था। मेरे ऑपरेशंस सर्वर के सामने लॉग-हेल्थ वर्कफ़्लो के एक रन में, रिमोट प्रोब को अपने आप में 5.428 सेकंड लगे और वह साफ़ तरह से बंद हुआ। उस प्रोब के चलने से पहले, उसी टर्न ने आवश्यक संदर्भ के 66,170 इनपुट टोकन को प्रोसेस करने में लगभग 7 मिनट 29 सेकंड खर्च किए। तेज़ हिस्सा टूल था। धीमा हिस्सा वह सब था जो वर्कफ़्लो को टूल कॉल करने से पहले चाहिए था।
एक उपयोगी क्लाउड एजेंट में केवल मॉडल का प्रतिक्रिया नहीं होती। उसके आसपास एक वर्कफ़्लो होता है: वे स्किल्स जो बताती हैं कि किसी कार्य को कैसे किया जाए, वे MCP कनेक्शन जो टूल और सेवाएँ उपलब्ध कराते हैं, वे अनुमतियाँ जो तय करती हैं कि क्या छुआ जा सकता है, और वह ब्राउज़र या शेल जो वास्तव में कार्य करता है। इसे लोकल रूप से दोहराने का अर्थ है पूरे सिस्टम को दोहराना, केवल चैट विंडो को मॉडल API से जोड़ना नहीं।
वर्कफ़्लो ही उत्पाद है, एंडपॉइंट नहीं
इस शब्दावली के दो हिस्सों को सीधे तौर पर परिभाषित करना उपयोगी है, क्योंकि अधिकांश कठिनाई यहीं है, मॉडल में नहीं।
MCP, यानी Model Context Protocol, एक तरीका है जिसके माध्यम से एजेंट होस्ट मॉडल को टूल और सेवाएँ उपलब्ध कराता है। प्रत्येक MCP सर्वर उन टूलों की एक सूची प्रकाशित करता है जिन्हें मॉडल कॉल कर सकता है, और उन टूलों के पीछे वास्तविक क्षमताएँ होती हैं: फ़ाइलें, रिपॉज़िटरी, ब्राउज़र, डेटाबेस और रिमोट सेवाएँ। होस्ट हर कॉल में मध्यस्थता करता है, और अनुमतियाँ भी यहीं लागू की जाती हैं।
स्किल्स वर्कफ़्लो निर्देश हैं। एक स्किल बताती है कि किसी प्रकार का कार्य कैसे किया जाए: कौन-से टूल इस्तेमाल करें, क्या एकत्र करें, किस क्रम में करें और आउटपुट में क्या होना चाहिए। यह मॉडल को एक प्रक्रिया देता है जिसका पालन करना है, हालांकि मॉडल फिर भी कुछ चरण छोड़ सकता है और उसे सत्यापन की आवश्यकता होती है।
इसलिए महत्वपूर्ण सिस्टम होस्ट, मॉडल, रंटाइम, अनुमतियाँ और टूल कनेक्शन — सब मिलकर है। होस्ट वह एप्लिकेशन है जिससे आप इंटरैक्ट करते हैं, मेरे मामले में Kilo Desktop, VS Code में Kilo और AnythingLLM। रंटाइम मॉडल को सेव करता है। मॉडल तर्क करता है। स्किल्स और MCP कनेक्शन तय करते हैं कि कौन-सा कार्य करना ही संभव है। केवल एक इन्फ़रेंस एंडपॉइंट एजेंट होस्ट के लिए इन स्किल्स, कनेक्शन या अनुमतियों को कॉन्फ़िगर नहीं करता।
मैं क्या चला रहा हूँ
मेरा सर्विंग स्टैक एक OpenAI-संगत llama.cpp सर्वर (CUDA, build b11852) है, जो Qwen 3 Coder Next (Q4_K_M) चला रहा है। मॉडल मेटाडेटा के अनुसार 48 परतों में कुल 79.67 बिलियन पैरामीटर हैं, और क्वांटाइज़्ड वेट लगभग 48 GB लेते हैं। मशीन में एक RTX 4090 है, जिसमें 24 GB VRAM है, एक Ryzen 9 3900X है, जिसमें 12 भौतिक कोर और 24 थ्रेड हैं, और 128 GB सिस्टम RAM है। कॉन्फ़िगर की गई संदर्भ क्षमता 131,072 टोकन है, जिसमें अधिकतम प्रतिक्रिया 8,192 टोकन की है।
Qwen 3 Coder Next एक mixture-of-experts मॉडल है। इसका अर्थ है कि यह कई अलग-अलग एक्सपर्ट वेट सेट संग्रहीत करता है और प्रति टोकन केवल उनमें से एक उप-समुच्चय को सक्रिय करता है। इसलिए संग्रहीत वेट बड़े होते हैं, भले ही प्रति टोकन गणना उनके केवल एक अंश को छूती हो। इस हार्डवेयर निर्णय के लिए संग्रहीत वेट का आकार महत्वपूर्ण है: क्वांटाइज़ेशन के बाद भी लगभग 48 GB।
मॉडल GPU पर क्यों नहीं समा सकता
24 GB VRAM के सामने लगभग 48 GB क्वांटाइज़्ड वेट एक अंकगणितीय समस्या है, ट्यूनिंग की समस्या नहीं। Q4_K_M क्वांटाइज़ेशन सटीकता और गुणवत्ता के समझौते के साथ वेट स्टोरेज कम करता है, लेकिन इस मॉडल को 24 GB में समानfit नहीं करता, खासकर तब जब संदर्भ और रंटाइम बफ़र को भी VRAM चाहिए।
समाधान विभाजित प्लेसमेंट है। 48 परतों में से पहली 32 की एक्सपर्ट वेट CPU/सिस्टम-RAM पक्ष को सौंपे जाते हैं; अन्य टेंसर GPU पर रहते हैं, जिनके साथ एक सीमित GPU एक्सपर्ट कैश होता है। स्पष्ट रूप से, यह केवल CPU पर चलने वाली 32 पूर्ण परतें नहीं हैं: mixture-of-experts मॉडल में उन परतों में एक्सपर्ट वेट होते हैं, और पहली 32 परतों के एक्सपर्ट वेट ही सिस्टम RAM में रहते हैं।
इसके साथ: 1,024 MiB एक्सपर्ट GPU कैश, Q8 KV कैश और Flash Attention। मॉडल वेट GPU मेमोरी उपयोग का केवल एक हिस्सा हैं। रंटाइम को वर्किंग बफ़र और अटेंशन स्टेट की भी आवश्यकता होती है, जिसे अक्सर KV कैश कहा जाता है। Q8 समर्थित कैश टेंसर की स्टोरेज सटीकता को नियंत्रित करता है। 1 GiB एक्सपर्ट कैश और Flash Attention आगे मेमोरी/गणना के समझौते हैं; इस रन में इनके व्यक्तिगत योगदान को अलग से मापा नहीं गया।
हर हिस्सा इसलिए क्यों मौजूद है
ये एक मशीन और एक वर्कलोड के लिए व्यावहारिक चुनाव हैं, बेंचमार्क द्वारा सिद्ध इष्टतम नहीं।
| चयन | कारण | योग्यता |
|---|---|---|
| llama.cpp runtime | स्पष्ट क्वांटाइज़ेशन और परत प्लेसमेंट नियंत्रण उपलब्ध कराता है, और OpenAI-संगत API प्रदान करता है जिसे एजेंट होस्ट उपभोग कर सकता है | एक runtime, मॉडल नहीं; इसे बदलने से वही मॉडल अधिक बुद्धिमान नहीं होता |
| कोडिंग-उन्मुख MoE मॉडल | चैट डेमो के बजाय वास्तविक कार्य और टूल वर्कलोड का समर्थन करने का प्रयास | फ्रंटियर क्लाउड मॉडल के बराबर सिद्ध नहीं; पहले के लोकल रन में अब भी मानवीय सुधार की आवश्यकता रही |
| Q4_K_M क्वांटाइज़ेशन | वेट स्टोरेज को इतना कम करता है कि हाइब्रिड प्लेसमेंट व्यवहार्य हो | सटीकता और गुणवत्ता का समझौता, मुफ़्त लाभ नहीं |
| CPU और GPU का विभाजन | VRAM सीमित है और वेट उससे अधिक हैं | 48 परतों में से पहली 32 की एक्सपर्ट वेट सिस्टम RAM में रहते हैं; बाकी GPU पर चलते हैं |
| 128K संदर्भ सीमा | निर्देशों, स्किल और टूल परिभाषाओं, कार्य के इनपुट, टूल परिणामों और आउटपुट के लिए अतिरिक्त जगह | कॉन्फ़िगर की गई क्षमता, प्रति टर्न आवश्यकता नहीं |
| एक समवर्ती अनुरोध, 12 CPU थ्रेड | उपलब्ध RAM और भौतिक कोर के सापेक्ष मेमोरी माँग को नियंत्रित करता है | अन्य वर्कलोड के लिए इष्टतम सिद्ध नहीं |
| मूल Windows सर्विंग | WSL VM की 32 GB RAM सीमा और Windows-माउंट की गई फ़ाइलों के माध्यम से मॉडल लोडिंग की अड़चन से बचा | Kilo के अपने Linux संचालन कमांड अब भी WSL के भीतर चलते हैं |
एक रन ने वास्तव में क्या किया
| चरण | अवधि | विवरण |
|---|---|---|
| इनपुट और संदर्भ को प्रोसेस करना | 448.92 s (7 min 29 s) | 66,170 प्रारंभिक इनपुट टोकन, प्रभावी रूप से लगभग 147 इनपुट टोकन/sec |
| रिमोट लॉग-हेल्थ प्रोब | 5.428 s | मेरे ऑपरेशंस सर्वर के सामना, exit code 0 |
| अनुवर्ती मॉडल प्रतिक्रिया | 20.1 s | 66,251 इनपुट टोकन पुनःउपयोग किए गए, 763 नए, 388 आउटपुट टोकन, लगभग 98.9% पुनःउपयोग किए गए |
ये एक रन के तीन अलग चरण हैं, समान-से-समक तुलन नहीं। 448.92 सेकंड एक वर्कफ़्लो में बड़े संदर्भ की कोल्ड प्रोसेसिंग थी, जिसे एक बार देखा गया। 5.428 सेकंड रिमोट प्रोब को अपना कार्य करने में लगा समय था। 20.1 सेकंड टूल के लौटने के बाद मॉडल का दूसरा चरण था। 449 सेकंड और 20.1 सेकंड को एक ही कार्य में त्वरित होने के रूप में पढ़ना गलत होगा, क्योंकि कार्य अलग था और दूसरे चरण को गर्म प्रिफ़िक्स विरासत में मिला था।
पुनःउपयोग कहाँ से आया
अनुवर्ती चरण ने 66,251 इनपुट टोकन पुनःउपयोग किए और 763 नए टोकन प्रोसेस किए, यानी लगभग 98.9% पुनःउपयोग हुआ। यहाँ दो अलग तंत्रों को आसानी से एक समझा जा सकता है, इसलिए उन्हें अलग करना उपयोगी है। KV caching अटेंशन स्टेट संग्रहीत करता है ताकि पिछले टोकन को हर जनरेशन चरण में उसी तरह फिर से गणना न करना पड़े; Q8 एक स्टोरेज-सटीकता चयन है। Prefix reuse एक व्यवहार है: इंजन ने देखा कि अनुरोध की शुरुआत वह प्रोसेस की हुई सामग्री से मेल खाती है और उस हिस्से को दोबारा प्रोसेस करने से छोड़ दिया। दोनों मॉडल वेट को नहीं छोटा करते, और दोनों क्लाउड बिलिंग छूट नहीं हैं। क्लाउड प्रदाता की इनपुट कैश की गणना एक अलग तंत्र है, जिसके अपने नियम और दरें हैं।
उपलब्धता एक अलग समस्या है
October 31, 2026 को, मेरा Kilo Desktop सत्र स्पिनर पर अटका रहा, इसलिए मैंने अटके हुए सत्र की जाँच करने का अनुरोध किया। कारण मॉडल की गुणवत्ता, संदर्भ का आकार या कोई टूल त्रुटि नहीं थी। लोकल मॉडल सर्वर बंद था। Kilo लगातार पुनःप्रयास कर रहा था और ECONNREFUSED प्राप्त कर रहा था, लेकिन स्पिनर के कारण कभी स्पष्ट नहीं हुआ।
सर्वर शुरू करने से मौजूदा सत्र बहाल हो गया। किसी संदर्भ को छोड़ने या कोई कार्य दोबारा करने की आवश्यकता नहीं पड़ी। स्थायी समाधान एक ऑन-डिमांड लॉन्चर था: सर्वर शुरू करें, तैयार होने की प्रतीक्षा करें, फिर Kilo खोलें। Windows साइन-इन में कुछ भी नहीं जोड़ा गया, जो मुझे पसंद आया क्योंकि मैं उस मशीन का इंटरैक्टिव उपयोग भी करता हूँ। llama.cpp और Qwen की सेटअप इससे पहले ही मौजूद थी; इस घटना ने सर्वर को शुरू करने का तरीका बदला, मॉडल को सर्व करने का तरीका नहीं।
इसे उल्लेखनीय है क्योंकि यह ऊपर दिए गए समय-मापन से उलटा सबक है। अनुपलब्ध सर्वर पर तेज़ मॉडल पूरी तरह कुछ भी उत्पन्न नहीं करता।
प्रॉम्प्ट लागत, ईमानदारी से
इस रन में प्रॉम्प्ट बड़ा था क्योंकि वर्कफ़्लो ने उसकी माँग की थी। निर्देशों, स्किल परिभाषाओं, टूल परिभाषाओं, कार्य और टूल परिणामों के लिए जगह मिलकर बड़ा आकार बनाते हैं, और मुझे संख्या को बेहतर दिखाने के लिए स्किल्स या MCP कनेक्शन हटाने में कोई रुचि नहीं है। किसी कट-कुटे हुए वर्कफ़्लो पर बना बेंचमार्क किसी कार्यरत एजेंट का वर्णन नहीं करता।
इसलिए लागत श्रेणियों की ईमानदार तुलना करें, उन्हें एक में न मिलाएँ।
क्लाउड योजनाएँ इनपुट टोकन, आउटपुट टोकन और कैश किए गए इनपुट के लिए अलग-अलग शुल्क लगा सकती हैं। अनकैश्ड इनपुट का शुल्क लगभग इनपुट टोकन को एक मिलियन से भाग देकर, फिर प्रदाता के प्रति मिलियन इनपुट मूल्य से गुणा करके निकाला जाता है। आउटपुट शुल्क और किसी भी कैश छूट पर निर्भरता प्रदाता और योजना पर निर्भर करती है। वास्तविक बिल इसलिए किस प्रदाता और किस मूल्य स्तर पर निर्भर करता है, और मैं इसके लिए कोई डॉलर राशि गढ़कर नहीं बताऊँगा।
लोकल इन्फ़रेंस उस लोकल मॉडल के लिए प्रति-टोकन API शुल्क हटा देता है। यह सशुल्क टूल या रिमोट सेवाओं के शुल्क नहीं हटाता, और यह निःशुल्क नहीं है। लागतें हैं हार्डवेयर, मेमोरी और VRAM क्षमता, बिजली की खपत, सेटअप का रखरखाव, उसके इंतज़ार में बीताया गया वास्तविक समय और आउटपुट की मानवीय समीक्षा। ये लागतें वास्तविक हैं और इन्फ़रेंस लोकल होने के कारण कम नहीं होतीं।
एक बात अक्सर छूट जाती है: लोकल इन्फ़रेंस रिमोट MCP कॉल को लोकल या ऑफ़लाइन नहीं बनाता। मेरे टूल अब भी नेटवर्क के माध्यम से रिमोट सेवाओं तक पहुँचते हैं। मेरी मशीन से बाहर जाने वाला कार्य टूल ट्रैफ़िक है, और क्या कॉल करना है, यह तय करने वाला मॉडल केवल एक्सपोज़र का एक हिस्सा है।
128K संदर्भ क्षमता को भी 66,170 प्रोसेस किए गए टोकन से अलग रखें। पहली एक सेटिंग है, दूसरी यह बताती है कि इस टर्न ने वास्तव में क्या भेजा। दोनों शुल्कयोग्य टोकन के बराबर नहीं हैं, और दोनों कार्य-पूर्णता की लागत के बराबर भी नहीं।
यह रन क्या दिखाता है, और क्या नहीं
देखा गया परिणाम सामान्य था और वास्तविक था: लाइव स्किल प्रोब मेरे ऑपरेशंस सर्वर के सामने पूरा हुआ, Kilo ने एक रिपोर्ट तैयार की और रिपोर्ट मानवीय समीक्षा के लिए प्रमाण के साथ वापस आई। प्रोब और प्रतिक्रिया पूरी हुई। इससे अकेले यह सिद्ध नहीं होता कि हर स्किल निर्देश का पालन किया गया था या हर निष्कर्ष सही था।
यही वह मानदंड है जिसकी वास्तव में मुझे परवाह है। पूर्णता और शुद्धता, गति नहीं। सात और आध मिनट का इंतज़ार स्वीकार्य परिणाम है, जब एजेंट अपनी स्किल का पालन करता है, सही टूल कॉल करता है और समीक्षा योग्य कुछ लौटाता है। अधूरा उत्तर इस वर्कफ़्लो के लिए कोई मूल्य नहीं रखता।
इससे यह नहीं निष्कर्ष निकलता कि यह सेटअप सामान्यतः विश्वसनीय है, फ्रंटियर क्लाउड मॉडल के बराबर है, या यहाँ के समय-मापन आपके अपने समय-मापन का अनुमान लगाते हैं। एक रन एक रन होता है। और प्रॉम्प्ट-प्रोसेसिंग समय का चार्ट मॉडल को ख feeding का लागत मापता है, उसके द्वारा उत्पन्न सामग्री की गुणवत्ता नहीं। पूर्णता, आउटपुट गुणवत्ता और समीक्षा की लागत तय करते हैं कि वर्कफ़्लो चलाने योग्य है या नहीं।
यदि आप लोकल रूप से एजेंट कार्य चला रहे हैं, तो आपका प्रॉम्प्ट-प्रोसेसिंग बजट क्या है, और आप कैसे तय करते हैं कि धीमे टर्न का इंतज़ार करना उचित है या नहीं?
प्रमाण संबंधी टिप्पणी: ये आँकड़े एक उपयोगकर्ता के October 31, 2026 को हुए एकल यंत्रीकृत लोकल रन से हैं, जिसमें एक वास्तविक वर्कफ़्लो पर अनुमानित समय-मापन दिए गए हैं। ये मानकीकृत बेंचमार्क नहीं हैं, नियंत्रित Ollama बनाम llama.cpp तुलना नहीं हैं, और न ही क्लाउड-बनाम-लोकल प्रदर्शन या लागत की तुलना हैं।